VS arresteren man voor smokkel van 300 miljoen dollar aan servers naar China
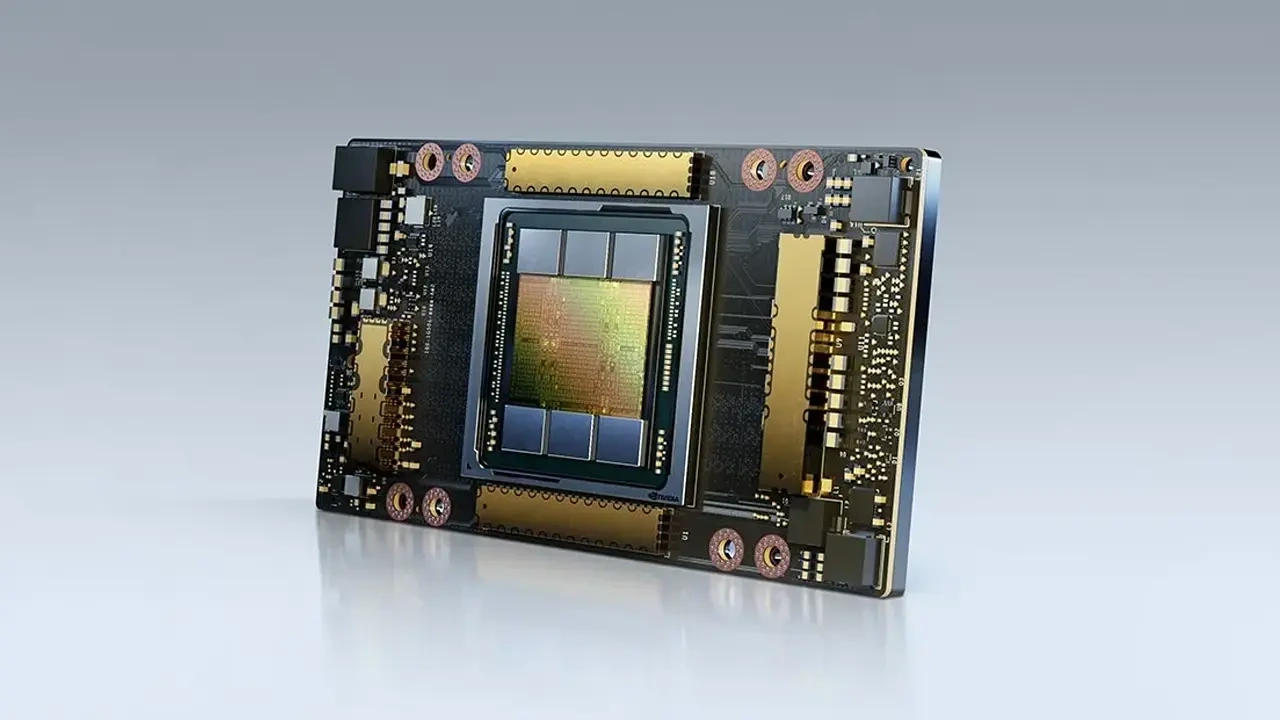
De Verenigde Staten hebben een man gearresteerd die ervan wordt beschuldigd voor meer dan 300 miljoen dollar aan computerservers naar China te hebben gesmokkeld. De servers zouden gpu's bevatten die in de VS zijn gemaakt en worden gebruikt voor 'superintelligentietoepassingen'.
Volgens het Amerikaanse ministerie van Justitie verkocht de 38-jarige Greg Lui de servers aan de Chinese regering en overtrad hij daarmee de exportwetten van de VS. De man zou zijn bedrijf hebben gebruikt om producten te kopen die onder de exportverboden vallen. Vervolgens gebruikte hij landen als Maleisië en Singapore als doorvoerlanden om de servers naar China te exporteren.
Lui leverde samen met zijn medeplichtigen valse papieren aan Amerikaanse fabrikanten. Daarin beweerden zij dat de producten bestemd waren voor eindgebruikers die niet onder het exportverbod vallen en bestemmingen waarvoor geen vergunning nodig is. Het bedrijf van Lui ontving volgens het ministerie meer dan 176 miljoen dollar van twee transportbedrijven in Maleisië.
Volgens de South China Morning Post exporteerde Lui onder meer A100- en H100-chips van Nvidia. Volgens de VS kunnen de geëxporteerde gpu's een 'aanzienlijke bijdrage' leveren aan het militaire potentieel van andere landen. Lui kan tot twintig jaar gevangenisstraf krijgen voor samenzwering, twintig jaar voor witwassen en tien jaar voor het smokkelen van goederen naar het buitenland.
Nvidia reageert tegenover Bloomberg positief op de arrestatie: "Deze zaak toont eens te meer aan dat smokkelen een verloren zaak is – juridisch, economisch en technisch. Onze samenwerking met rechtshandhavingsinstanties heeft geleid tot strafrechtelijke vervolgingen, en we zullen met hen blijven samenwerken."

Lees meer


Reacties (113)

Als je een nvfp4 gekwantificeerd model wilt draaien:
- Blackwell (Spark, B200, .., 5090) : n VRAM nodig
- Hopper (H100, ... , 4090): 2 x n VRAM nodig want geen fp4
- Ampère (A100, ..., 3090): 4 x n VRAM nodig want geen fp8 op de server.
Stroom verbruik
Voor het draaien van hetzelfde taalmodel als op een DGX Spark met maximaal 140W gebruikt en 128GB geheugen, heb je een Ampère systeem met 14.000W aansluitwaarde en 512GB geheugen nodig.
Ter vergelijking de opvolger van Blackwell is ongeveer 3x efficiënter. Een Robin data center GPU kan in 6 seconden ongeveer 10 seconden aan 4k video en audio genereren. Typisch koop je systemen met 8 of meer van die GPUs.
* NVPF4 wordt naast MXFP4 tegenwoordig het meest gebruikt of efficiënt en met zo hoog mogelijke accuraatheid een taalmodel te draaien op je GPU:
https://developer.nvidia....-low-precision-inference/
https://huggingface.co/bl...alimatti/learn-ai-with-me
Een ouder voorbeeld van een model dat zo geoptimaliseerd is https://arxiv.org/abs/2508.10925 hierdoor paste voor het eerst een 20B taalmodel op een 16GB video kaart.
[Reactie gewijzigd door djwice op 3 oktober 2026 17:16]

[Reactie gewijzigd door Zoijar op 3 oktober 2026 15:39]

Daardoor zal deze net als de NVIDIA Ampère familie 3 tot 4x zo veel geheugen nodig hebben als een moderne NVIDIA GPU.
De nieuwste versie van de modellen die IBM liet zien in haar test met Nordpole:
https://huggingface.co/ibm-granite/granite-4.2-8b-nvfp4
draait op 1 DGX spark met 1 gebruiker tegelijk al met 65 tokens per seconde, waar IBM Northpole er nog geen 28 haalt met 16 units van elk 74W.
Maar omdat Granite 8B een extreem klein model is voor die 128GB geheugen van een DGX Spark, kunnen er tientallen gebruikers tegelijkertijd met ongeveer 60 tokens per seconde elk op 1 machine werken. Je komt in tests op ruim 1500 concurrent decoding tokens per seconde op een DGX Spark voor dit model.
Ik vermoed dat de architectuur van IBM 1 gebruiker tegelijkertijd kan verwerken - en ook nog eens 3 tot 4x zo veel geheugen nodig heeft als NVIDIA Blackwell om het model met dezelfde nauwkeurigheid uit te voeren.
Het is niet voor niets dat er geen IBM, Apple, Qualcomm of AMD hardware gebruikt wordt om meerdere gebruikers tegelijkertijd het zelfde AI model te geven. NVIDIA heeft dat complexe gedeelte, concurrent berekeningen, heel goed op orde. Op dit moment is dat ongeëvenaard.
[Reactie gewijzigd door djwice op 4 oktober 2026 17:12]

En als ik naar het gebruik bij experts op het werk kijk en naar presenterende experts: de expert gebruikt €800 tokens per maand.
De gene die pretenderen verstoken zo €50 per prompt waar de expert het zelfde bereikt met €0,10.
Wellicht wordt er goede marge gemaakt op de pretenderende mensen. Maar zelfs voor de expert kan lokale hardware al terugverdiend worden. Ook als de volgende generatie zo veel efficiënter is.
Er zijn trouwens nog veel bedrijven die nieuw zijn met het hebben van GPU's in het data centrum en gewend waren een of twee oudere generatie CPU's te kopen omdat het niet heel veel uit maakte maar wel veel scheelde in aanschaf prijs. Bij GPU's gaat dat op dit moment niet op, maar toch kijken ze naar RAM + aantal cores en denken dat oude hardware bijna gelijk is. En 'besparen' dan 7% in aanschaf, terwijl ze eigenlijk de helft of een kwart aan capaciteit kopen.
De marge op de hardware is extreem hoog. Dat was 72% en zal nu rond de 250% liggen.
Dat geeft heel veel mogelijkheden tot heen en weer schuiven van geld.
Het beeld dat geschept wordt is dat het een race is en er maar 1 winnaar kan zijn, en dat die uiteindelijk alle macht en dus geld zou krijgen.
Het kan zijn dat dit niet waar blijkt te zijn. Er zijn landen die een groot deel van hun economie richten op geld verdienen aan angst creatie.
Laten wij onze maatschappij bouwen op er voor elkaar zijn en met elkaar zijn.
[Reactie gewijzigd door djwice op 4 oktober 2026 09:24]
Er zijn wat werkgebieden waar flink geld te verdienen valt met hele goede AI modellen die duizenden Watts gebruiken om een mens te vervangen.
Maar die miljarden zie ik ze niet terugverdienen. Zeker niet nu alles een beetje aan het afkoelen is.

Met 2x A100 heb je wel 800w aan stroomverbruik, maar je hebt zoveel meer compute en geheugen bandbreedte dat je compleet gehakt gaat maken van die DGX in elke, ook maar enigszins goed geoptimaliseerde vergelijking. Laat staan wat er gebeurt bij 14kw.
Bovendien is het over het algemeen verstandig de safetensors te gebruiken en die indien gewenst om te zetten naar het formaat naar keuze. GGUF kan kwaadaardige dingen bevatten.
Een DGX Spark heeft 1 PFLOP fp4 sparse.
500 TFLOPS dense.
Voor elke fp4 moet de A100 een fp16 berekening maken.
Voor elke fp8 KV-Cache een fp16 plek reserveren.
Dus voor een nvfp4 model dat op de DGX Spark of Blackwell B200 110GB geheugen gebruikt heb je dus al snel 440GB nodig op een A100. Dat zijn er ruim meer dan 2, minimaal 6 A100 kaarten zelfs. Had je de netwerk, GPU linking, CPU, opslag, voeding en koeling ook al meegenomen in het stroomverbruik? Want bij de Spark zit dat al in de 140W.
Kijk je naar geheugen bandbreedte, ook die moet 4x groter zijn op de A100 t.o.v. Blackwell om dezelfde berekening over de bus te kunnen halen. Je hebt dus minimaal 273Gb/s x 4 = 1092Gb/s nodig om de bussnelheid van de DGX Spark te evenaren voor dezelfde nvfp4 berekeningen. De bandbreedte van een lane tussen twee A100 GPU's is maximaal 25GB/s. Dat is trager dan 273Gb/s en zeker trager dan 1093Gb/s.
[Reactie gewijzigd door djwice op 5 oktober 2026 01:07]
Dat hangt er echt heel erg van af hoe je "vele malen" defineert, als je BF16 versie een 99% succes rate heeft en GGUF Q4_K_S een 96%, dan gaat je performance tegelijkertijd met factor 4 omlaag en met 3 procent punt. Afhankelijk van je use case is dat catastrofaal slecht of een complete non-issue.Een int4 versie in een GGUF is echt vele malen minder nauwkeurig dan een nvfp4 of fp16 versie van een model. Bij redeneer modellen heeft dat vaak impact op het simpelweg foute antwoorden op de vraag, in een loop raken, vergeten van input , etc.
Het blijft belangrijk om het grote plaatje te zien, bijvoorbeeld met FP16 verlies je wat accuracy tov BF16, omdat er in FP16 geen cijfers over 65536 mogelijk zijn, maar als je model dus geen enkele weight boven 64k heeft, dan is er letterlijk geen verschil.
Datzelfde geldt voor GGUF vs BF16, als BF16 je niks extra kost tov GGUF, dan is het een no-brainer, maar zo werkt de wereld helaas niet. Als je tegen de limiet van je ram aan zit kun je bijna altijd beter een groter model runnen in 4 bit, dan een kleiner model in BF16. Het performance verlies van 4 bit is veel kleiner dan wat je wint door een 27b ipv 9b model te runnen bijvoorbeeld.
Je hebt technisch gezien gelijk dat de worse case tussen een NVFP4 en INT4 vrij grimmig is, maar in de praktijk ga je natuurlijk niet je AI stack gebruikten op de meest inefficiënte manier mogelijk. Ga maar eens een Qwen 3.8 27b NVFP4 van 22gb vergelijken met een Qwen 3.8 27b Q6_K van 22gb en een Qwen 3.5 9b BF16 van 19,25 gb.
Ik durf te wedden dat BF16 die vergelijking niet wint

Dit vind ik overigens een bijzondere opmerking. Nvlink bestaat niet uit één lane. Je hebt op A100 600gb/s aan totale nvlink bandbreedte. Nu levert Nvlink voor inference meestal niks op, maar dat even terzijde.De bandbreedte van een lane tussen twee A100 GPU's is maximaal 25GB/s. Dat is trager dan 273Gb/s en zeker trager dan 1093Gb/s.
Zoals je weet is 'in 4-bit' in in het geval van A100 een 4-bit integer met 16 verschillende waardes, met gelijke afstand en met het hoogste cijfer 15, dat is een wereld van verschil met FP16 en BF16.
Maar samengevat ben je het dus eens met dat een model dat 110GB geheugen op Blackwell nodig heeft in NVFP4 dus de dingen nodig heeft op A100 die ik aangeef.
Alleen dat je daarom in de praktijk dat model niet zal gaan draaien maar een groter model in int4.
Dat grotere model zou dan met een nauwkeurige Quant ook draaien op het Blackwell platform. En geldt dus wederom hetzelfde.
De nvlink heeft inderdaad meer dan 1 lane, mijn indruk is dat niet meerdere lanes gebruikt worden tussen het geheugen van twee GPU's in de zin van parallelle data transport in een richtinb tijdens het uitvoeren van het model, maar ik heb geen A100's dus heb dat zelf niet getest.
Ik zag pas een 14kW aansluitwaarde machine met 8 x A100 aangeboden voor de prijs van een DGX Spark dus vandaar dat ik toen wat berekeningen gedaan heb rondom efficiëntie en wat er op kan draaien.
Dat bleek minder dan een Spark te zijn voor dezelfde modellen.
[Reactie gewijzigd door djwice op 5 oktober 2026 20:04]
De grap is, dat is dus niet zo. Een Q4_K_S (of M/XL) of INT4 quant is niet alleen INT4. Per groep van bijv. 256 of 128 weights is er één FP16 waarde, die dient als reference voor de rest van de 4 bit waardes binnen het blok. Bijvoorbeeld alles keer 10 of alles keer 51,3. Whatever. Bij een Q4_K_S/M/XL quant komen daar nog meer waardes tussen die elk blok in sub blokken verdelen. Dat maakt dat je dichter bij een BF16 origineel zit, dan een "normale" INT4 of FP4, met voor een M of XL meer delen in hoge precisie.GGUF is een bestandsformaat dat modellen in verschillende vormen kan opslaan BF16 is daar een van.
Zoals je weet is 'in 4-bit' in in het geval van A100 een 4-bit integer met 16 verschillende waardes, ... dat is een wereld van verschil met FP16 en BF16.
Een NVFP4 quant is niet anders, de vier bits van NVFP4 zijn namelijk ook maar 15 verschillende waardes (want plus nul en min nul is hetzelfde
). Het verschil tussen INT4 en NVFP4 is dat je bij INT4 altijd stappen van 1 hebt, terwijl je bij FP4 kleinere stappen hebt in de buurt van nul en grotere stappen aan beide uitersten van de range. Dus waar een weight bij INT4 altijd nul of één of 2, etc moet zijn, kan bij FP4 ook 0,5 en 1,5. Andersom, is het minimum en het maximum bij NVFP4 plus of min 6, en dan de volgende stap is 4. Vijf kan niet, 7 ook niet. Bij INT4 zou dat wel kunnen.
Zal er een verschil zijn tussen INT4 en NVFP4, zeker, maar een model dat genoeg heeft aan 15 verschillende waardes, zal doorgaans ook wel genoeg hebben aan 16 verschillende waardes. Je verliest iets, maar het is geen wereld van verschil.
GGUF met een Q4_K quant zal altijd ietsje dichter in de buurt komen bij BF16, maar met GGUF moet je elke berekening 2x terug rekenen om bij de originele waarde te komen, terwijl dat bij INT4 of FP4 maar één keer hoeft. Het is een soort LLM.zip of .rar, je bespaart ruimte, maar het kost compute om in te pakken en weer uit. Bij mijn 3090 is het verschil ongeveer factor 2.5 tussen een INT4 en GGUF 4 bit model in totale tokens per seconde.
Ja, maar je mist hier een beetje de open deur: de 8x A100 machine verbruikt 14kw. Dat ie vele malen krachtiger is dan een DGX spark, wil niet zeggen dat ie wint in de real world. Een DGX Spark kun je op je bureau neer zetten en gebruiken voor allerlei leuke AI projecten, met kleine tot middelgrote modellen, terwijl 8x A100 een machine is die je per uur meerdere euro's aan winst moet opleveren om alleen de stroom te betalen, laat staan de rest van het DC.Ik zag pas een 14kW aansluitwaarde machine met 8 x A100 aangeboden voor de prijs van een DGX Spark dus vandaar dat ik toen wat berekeningen gedaan heb rondom efficiëntie en wat er op kan draaien.
Dat bleek minder dan een Spark te zijn voor dezelfde modellen.
Modellen van 300 - 600 b parameters zijn leuk, maar dan moet je er echt wel een serieuze use case voor hebben en zeker weten dat ie lang genoeg relevant blijft om een nieuw datacenter uit de grond te stampen en je netbeheerder te vragen om een grote stroom aansluiting.
Overigens ik neem aan dat je bedoelt zelfde prijs per uur? Want een A100 is op ebay nu ongeveer 2500 euro waard, dus als je er acht kan kopen voor 5000 dan zou ik dat zeker doen.
In een systeem met 8x A100 zul je 6 nvlink switches hebben, met per switch 2 lanes naar elke GPU, dan kun je dus de hele bandbreedte gebruiken van één gpu naar elke willekeurige andere, met 4x A100 is het simpeler om naar elke andere gpu 4 lanes te sturen.De nvlink heeft inderdaad meer dan 1 lane, mijn indruk is dat niet meerdere lanes gebruikt worden tussen het geheugen van twee GPU's in de zin van parallelle data transport in een richtinb tijdens het uitvoeren van het model, maar ik heb geen A100's dus heb dat zelf niet getest.
Dataoverdracht op een GPU is bijna altijd parallel over meerdere lanes. PCIE is ook bijv. 16 of 8 lanes en daar merk je als gebruiker niks van.
Ik heb volgens mij niet gezegd dat NVFP4 een 4-bit quant is, dat is het immers ook niet. Ik heb gezegd dat de Ampère architectuur alle berekeningen hierin in fp16 moet doen en dat dit 3-4x meer geheugen kost.
En ook de KV-cache van fp8 op fp16 in het geheugen kwijt moet.
Ik gebruik meestal vllm of sglang, geen llama.cpp. Dit in verband met concurrency.
GGUF zou ik alleen zelf maken van een safetensors model indien nodig of een gevalideerde veilige bron.
Waarom kies jij GGUF en niet safetensors?
Ja, 8 A100 incl, de rest van de blade met cpu, 4 voedingen etc. voor $3500 excl. transport en import heffing. Maar ik draai vooral nvfp4 modellen i.v.m. het weinige kwaliteitsverlies t.o.v. het origineel. Ik heb ook EXL3 in 2.75 getest van dezelfde modellen, die vielen vrij snel door de mand.
Heb ook een machine met NPU voor int4 en. GPU voor fp16, maar merk echt te veel verschil.
Dus vandaar.
Een Q4_k_s is meestal tussen 3.5 en 4 bits per weight. Ik zou zeggen een 3.9 bit quant is voor het gemak een 4bit quant...Ilk noem Q4_0 een 4-bit quant, als je er tussendoor fp16 tussen doet is niet alles 4-bit.
Je hebt gelijk in het deel dat ampère geen nvfp4 ondersteunt, maar de implicaties hiervan zijn anders dan je denkt. Ik heb het getest op m'n 3090 en een fp8 of fp4 KV kan prima. Wat er gebeurt is dat het fp8 in ram is en dan als ie iets moet berekenen, rekent ie het on-the-fly om naar een number format dat ie wel ondersteunt.Ik heb volgens mij niet gezegd dat NVFP4 een 4-bit quant is, dat is het immers ook niet. Ik heb gezegd dat de Ampère architectuur alle berekeningen hierin in fp16 moet doen en dat dit 3-4x meer geheugen kost.
En ook de KV-cache van fp8 op fp16 in het geheugen kwijt moet.
Het kost je dus geen ram, maar compute. Hetzelfde geldt voor bf16 op een nvidia T4. Het kan prima, maar omdat ie dat niet native ondersteunt, verlies je throughput tov een equivalente kaart die dat wel doet.
Non supported number formaten kosten je dus nauwelijks ram, maar wel compute. Om 4 bit te berekenen met een 16bit pijplijn is niet zo moeilijk, je zet er gewoon heel veel nullen voor en achter, maar dan ga je dus niet de speed-up hebben die 4x4 bit ipv 1x16 bit je normaal oplevert.
Je kunt GGUF ook met vllm aanbieden. In my testing is Q4_k_s aanzienlijk kleiner dan INT4 of NVFP4, dus het levert je meer context window op. Je zult de specifieke quant die je gebruikt natuurlijk moeten valideren voor je use case, maar dat is bij een safetensors BF16 of NVFP4 bestand niet anders.Ik gebruik meestal vllm of sglang, geen llama.cpp. Dit in verband met concurrency.GGUF zou ik alleen zelf maken van een safetensors model indien nodig of een gevalideerde veilige bron.
Waarom kies jij GGUF en niet safetensors?
Even ter vergelijking:
gguf (vllm) is ~130 t/s, 110k context,
int4 awq (vllm) is ~350 t/s, 70k context,
ninfer int4 is ~350 t/s, 130k context.
Allen qwen 3.8 27b op één 3090, met fp8 KV, 8-32 concurrent requests.
Prefill is max ~1300 t/s, dus met KV in fp4 kun je 262k context aanbieden, maar dan is lange requests alsnog een aardige onderneming.
Ik ben eigenlijk wel benieuwd hoe awq int4 (w4a16), Q4_k_m (of s/XL) en NVFP4 het doen in je use case kwa puur accuracy van het model alleen. Als je blackwell hebt zou ik zeker van de meer geavanceerde features gebruik maken, maar voor veel van dit soort dingen is het beter om te testen, dan om aannames te doen.Maar ik draai vooral nvfp4 modellen i.v.m. het weinige kwaliteitsverlies t.o.v. het origineel. Ik heb ook EXL3 in 2.75 getest van dezelfde modellen, die vielen vrij snel door de mand.
Heb ook een machine met NPU voor int4 en. GPU voor fp16, maar merk echt te veel verschil.
Ik kan me idd goed voorstellen dan exl3 met 2.75 bpw vrij bagger is. In mijn ervaring is ~4 bit wel een goed minimum om een bruikbaar model over te houden. Eronder valt het vrij snel in diggelen.
Ik vraag me af wat voor blade er 8x A100 heeft. Bedoel je gewoon een 1u? Een 2u 4 blade server (oid) met a100's lijkt me een interessante ervaring. Net een soort vulkaan
Safetensors is een JSON gebaseerd bestandsformaat dat Hugging face heeft geïntroduceerd omdat in de binaire formaten zoals gguf vaak malefide code werd geïnjecteerd.
Q4_k_s kan dus ook prima als safetensors worden gedistribueerd.
Maar goed het aantal tokens per seconde zegt niets over de kwaliteit van de output en het begrijpen van de input.
Zoals inmiddels ook op tweakers in het nieuws is geweest heeft die sanctie er toe geleid dat Chinese bedrijven steeds meer lokale hardware zijn gaan kopen en dat de ontwikkeling, evolutie en productie daarvan een enorme vlucht heeft genomen.
[Reactie gewijzigd door djwice op 5 oktober 2026 19:03]
Je eindconclusie over dat de Chineze zelf slimme oplossingen gaan maken kan ik alleen maar onderschrijven. Wat is het Nessecity is the mother of invention? Als je de mensen zonder iets zet dat ze willen hebben gaan ze gewoon zelf iets maken.


[Reactie gewijzigd door zrx0 op 5 oktober 2026 00:23]
Misschien wel juist China houd je hier niet mee tegen.

Een handige smokkelaar verkoopt dus aan verschillende van die kleine winkeltjes en laat zijn spoor daar doodlopen. De winkels verkopen dan op hun risico door. Wie meer wil verdienen verkoopt zelf door naar China, maar met een risico om tegen de lamp te lopen.
De Chinezen zijn niet dom en waar ze niet zo klein kunnen als wij in productie maken ze gewoon innovatie op andere punten voor hetzelfde resultaat. Of zetten gewoon een server extra neer.
Met chip export had Amerika en afhankelijkheid kunnen creëren. Nu jagen ze onafhankelijkheid alleen maar aan. En geven ze China alleen maar meer kaarten en zichzelf minder. Want China heeft nog steeds de zeldzame aardelementen kaart. En die hebben ze nog steeds terwijl ze Amerika straks niet meer nodig hebben.


https://www.reddit.com/r/Microcenter/comments/1wul71a/form_for_5090s/


Ja, Taiwan bedoel je natuurlijk


Kunnen we AUB die term "superintelligentie" niet adopten op Tweakers ?De servers zouden gpu's bevatten die in de VS zijn gemaakt en worden gebruikt voor 'superintelligentietoepassingen'.
Trump's exacte woorden uit https://www.presidency.ucsb.edu/documents/remarks-the-united-nations-general-assembly-new-york-city-21:A superintelligence is a hypothetical agent that possesses intelligence surpassing that of the most gifted human minds
Dat heeft dus absoluut niks met de ASI (Artifical Super Intelligence) van David Chalmers te maken.The United States also totally rejects any attempt to construct a globalist scheme to control for the artificial intelligence being spoken of so much now here and after officially called superintelligence, changing the name, and that the use of the word artificial makes intelligence fake, it makes it sound fake.
Respectloos tegenover het lichaamsdeel.

Integendeel, die gesmokkelde chips kwamen aan op hun bestemming en kunnen worden gebruikt."Deze zaak toont eens te meer aan dat smokkelen een verloren zaak is – juridisch, economisch en technisch."
Altijd leuk die Amerikaanse semi-macht quotes 😆.
Geen enkele cijfers en null onderbouwing. Wel blij dat ze net 1.3% van de smokkelwaar hebben tegengehouden 😎...

Nou precies! Hou hier alsjeblieft mee op zeg, we hebben het over AI toepassingen, iedereen noemt het zo, hou op met die narcist na te papegaaien en mee te doen aan het normaliseren van zijn onzin…De servers zouden gpu's bevatten die in de VS zijn gemaakt en worden gebruikt voor 'superintelligentietoepassingen'.
Het gaat hier puur over LLM chatbotjes.

Geloof en ge zult zalig worden, ahum.Nvidia reageert tegenover Bloomberg positief op de arrestatie: "Deze zaak toont eens te meer aan dat smokkelen een verloren zaak is – juridisch, economisch en technisch. Onze samenwerking met rechtshandhavingsinstanties heeft geleid tot strafrechtelijke vervolgingen, en we zullen met hen blijven samenwerken."
Nvidia is in deze gewoon ontzettend dubbel want uiteindelijk hebben zij er wel weer via een omweg goed aan verdient. En het is dat er dan nu een export verbod is maar toen dit er nog niet was exporteerde Nvidia met alle plezier hun chips naar China. Ze willen zich dus nu netter voor doen maar Nvidia is en blijft gewoon een commercieel bedrijf. Als zij een omweg gevonden hadden om meer winst te maken hadden ze dat zeker gedaan.
Om te kunnen reageren moet je ingelogd zijn