Nvidia RTX PRO 5500-gpu heeft 84GB geheugen en evenveel CUDA-cores als RTX 5090
Nvidia heeft de RTX PRO 5500 Blackwell Workstation Edition onthuld. De AI-accelerator heeft 84GB GDDR7-geheugen met error-correcting code (ECC) en 21.760 CUDA-cores, evenveel als de RTX 5090. De tgp van de kaart bedraagt 600W.
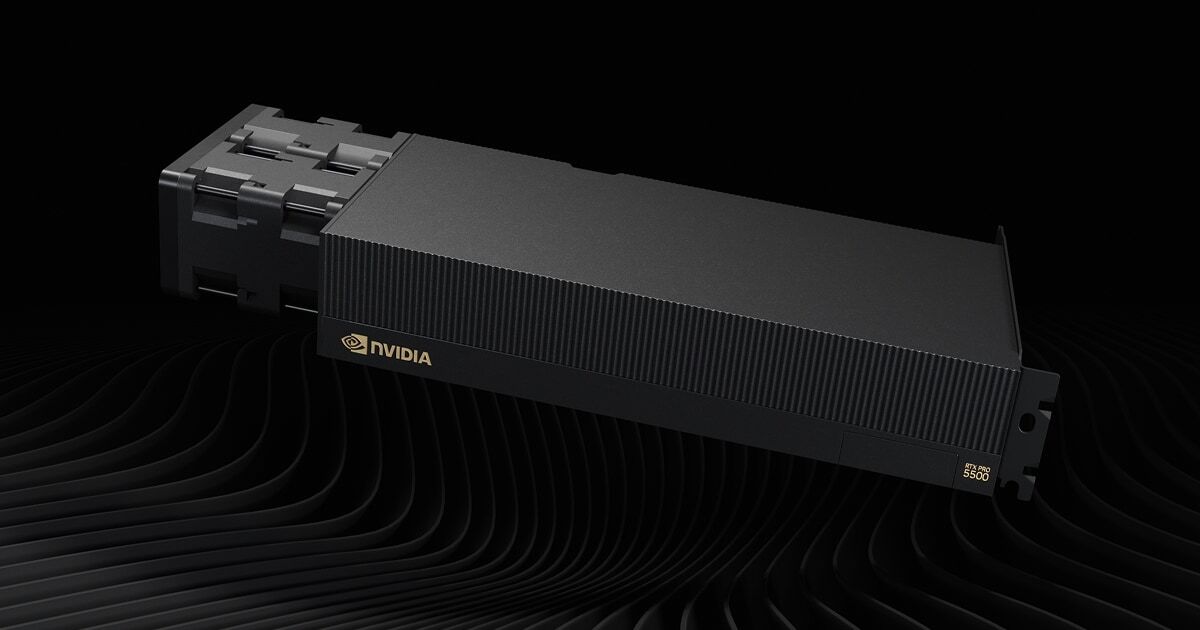
De RTX PRO 5500 gebruikt volgens PNY een GB202-die met een 416bit-geheugenbus en een geheugenbandbreedte van 1398GB/s. Mogelijk klopt die informatie niet volledig: de GB202-gpu heeft in totaal zestien 32bit-controllers. Daarom zou het logischer zijn als de kaart een 448bit-geheugenbus heeft, zoals onder meer de RTX PRO 6000D. Dan zouden veertien van de zestien controllers actief zijn, met elk twee modules van 3GB om op de totale geheugenhoeveelheid van 84GB uit te komen.
Het geheugen op de RTX PRO 5500 ondersteunt ook ECC. Dat corrigeert automatisch fouten in data in het werkgeheugen om crashes te voorkomen.
De kaart gebruikt PCIe 5.0 x16 en biedt vier DisplayPort 2.1b-uitgangen. De RTX PRO 5500 ondersteunt ook Multi-Instance GPU. De kaart kan daardoor functioneren als één instance van 84GB of twee afzonderlijke instances van 42GB. Nvidia levert de gpu in uitvoeringen met lucht- of waterkoeling. Er zijn nog geen prijzen bekend.
| CUDA-cores | Geheugen | Bandbreedte | Tgp | |
|---|---|---|---|---|
| RTX PRO 6000 | 24.064 | 96GB GDDR7 | 1792GB/s | 600W |
| RTX PRO 5500 | 21.760 | 84GB GDDR7 | 1398GB/s | 600W |
| RTX PRO 5000 | 14.080 | 48/72GB GDDR7 | 1344GB/s | 300W |
| RTX 5090 | 21.760 | 32GB GDDR7 | 1792GB/s | 575W |

Lees meer


Reacties (71)
Kan ik mooi zo een kaart gaan halen dadelijk.


Hetzelfde voor RAM en opslag. Achteraf had je er een compete hypotheek in willen stoppen

Maar dat is altijd zo 'achteraf'
Ik had ook bijna 2500 euro liggen...
Daar had ik makkelijk een paar knappe SSD's voor kunnen kopen 'vorige jaar'
voor 110-120 euro.. dan had ik nu ook gewoon 'even' een 1800-2300 euro 'extra' kunnen verdienen met doorstoten
Ofwel mijn geld verdubbelen, daarvoor had ik wel 22 2TB SSD een jaar lang in de verpakking moeten laten liggen.
Of toch in september 2016 'even' voor 10 rooie een bult bitcoins kopen.. van 550 euro per coin.. en dan in september 2025 verkopen.. dus 'even' 10 jaar vergeten en dan 93.5K per coin cashen met 550 euro per coin inleg.. ofwel 1.69 miljoen winst draaien
Maargoed dat is ALLEMAAL achteraf... kijkt men een koe in de (....) tja...
[Reactie gewijzigd door MalamuteOC op 15 september 2026 14:54]
Als je je eigen schaapjes op het droge hebt, dan kan je kijken of je 'misschien' genoeg overhoud in deze alsmaar duurder wordende samenleving om 'misschien' wat bijdrage te leveren aan de samenleving.
Want werken EN belasting betalen is voor mij al genoeg 'bijdrage' imo.

Toen maar een flagship 5080 voor 1800 gekocht toen ik er uberhaubt eindelijk één kon vinden die niet direct werd opgekocht.
Maar dat is nu al de 3e launch waar ik de FE kaarten in Duitsland / Frankrijk niet heb kunnen kopen. (NL zelf is al helemaal kansloos, amper 1% van de order aanmeldingen voldaan)
En dat is al met automatisering, hoewel een Distil setupje ondertussen allang niet meer onderscheidend is.
Heb uiteindelijk gewoon nooit een 5090 voor minder dan 2759 in het wild op voorraad gezien.


We hebben inmiddels maar een wireview pro II aan de 5090's gehangen want holy moly wat is het erg gesteld. Ineens hangt er een $5k+ stuk hardware in je PC. Moet er niet aan denken dat 'ie affikt.
Soms denk ik "verdikkeme, had ik die andere twee ook maar doorgezet" maar aan de andere kan zou ik me bijzonder slecht voelen over meedoen aan scalpergedrag dus nah.

Uiteindelijk heeft hij die kaarten een paar maanden terug verkocht (voor 4500 a 5200) en heeft in augustus ook z'n eigen 5090 maar weggedaan voor een 9070XT.
En van die winst een Nissan Skyline gekocht...
Ondertussen is m'n PC een jaar later gewoon flink gestegen in prijs. En dan heb ik ook nog eens teveel betaald voor m'n GPU toen die net uit was. Het is alleen maar heel even beter geworden en nu gewoon weer duurder.

[Reactie gewijzigd door Turismo op 15 september 2026 16:31]
Maar toch vond het wel grappig dat een "gelegenheids scalper en liefhebber" juist gezien de discussie precies dat deed; van GPU's naar auto ipv andersom.

Moest wel 30 jaar wachten.


30% rendement lijkt mij geen slechte investering. Had ik er maar 20 gekocht.


Kijk je kan er een aardig spelletje mee spelen.
Interessant voor bedrijven die data niet naar de cloud willen sturen:
- Contracten
- Klantgegevens
- Servicehistorie
- Financiële rapporten
- Productdocumentatie

Je moet het lokaal hosten niet doen vanwege het geld, maar er zijn genoeg andere redenen natuurlijk.

Gezien de grote broer PNY RTX PRO 6000 Blackwell Server Edition: beste prijzen, echte reviews en specificaties - Tweakers 18k kost, en qua tokens/sec, en startup veel sterker is dan een mac, heb je eigenlijk gewoon een heel ander product.
Naast LLM's zijn er natuurlijk ook andere workloads, ik kan me niet voorstellen dat je op een mac lekker met CuPY aan de gang gaat om absurde hoeveelheden lidar/afbeeldingen te analyseren/verwerken. Er is meer AI dan alleen tekst/generatief immers.
Maar dan alsnog zit je op 32 tokens op de M5 en over de 200 op de Grace Blackwell hardware. Het moment dat je naar "te grote" modellen gaat, dus voorbij 27B of dat niveau + Reasoning, stort de Blackwell in naar 50 tokens per seconde, terwijl de M5 er één inlevert. Een stuk dichterbij.
De 5090 of PRO 5000 zitten daar met op de core 150+ tokens/s ook behoorlijk overheen. Alleen kan je dan hetzelfde grote model natuurlijk niet draaien. vLLM bf16 of nvfp4 geeft opeens een heel andere invulling, maar het dan met iets meer dan 100 tokens ook gewoon weer een heel ander soort product.
Natuurlijk, de Mac kan veel meer soorten dingen doen. Maar als je een paar duizend euro uit gaat geven aan een dergelijke oplossing, dan ga je niet ook eens wat video bewerken en een mailtje tikken op diezelfde hardware. En voor een niche oplossing, wil je uiteindelijk gewoon dé beste oplossing kopen. De scores van de M5 Ultra zijn zeker niet verkeerd, maar niet hier nog daar in de praktijk.
(en zo'n 60k armer).Wil je 2TB aan video geheugen met de RTX PRO 6000 (met "slechts" 96GB) dan heb je 21 van die krengen nodig, dat is 400.000 euro voor alleen de videokaarten. Met de rest eromheen zit je waarschijnlijk tussen de 5 a 6 ton. Natuurlijk is dat sneller, maar het kost dan ook tien keer zoveel.

Die mac ultras gaan het voordeel hebben van veel, veel meer unified memory (512GB) en hebben ook al 1,3TB bandbreedte en zijn nog eens superzuinig ook
De toekomstige testen zullen het wel uitwijzen, maar mijn aanvoelen is dat wanneer je geen privacy bezwaren hebt je beter je workloads online kunt laten afhandelen en wachten tot de prijzen van hardware gaan afkoelen
[Reactie gewijzigd door klakkie.57th op 15 september 2026 15:46]
Nogmaals, ik vlak Apple niet af. Voor single user inference is het namelijk best wel de bang-for-bucks king specifiek op FP8 stijl taal/afbeelding modellen. Dit is namelijk eigenlijk niet compute bound, maar idd eerder memory bound. Zodra je iets doet waar compute ook bij kijken, dan is apple vooral een schattig stukje edge compute, en dan zal ik eerder zeggen: "gebruik de tooling, en de taal waar het ook op gebouwd wordt, en zet een DGX Spark neer, of voor mid size: een RTX Pro 5500/6000". Er is een reden dat B200 echter bestaat... en dat Metal eigenlijk ALTIJD later komt. Er zit wel wat werk op VLLM metal, maar dat loopt echt nog wel achter op de ontwikkelingen voor nVidia, of zelfs: RocM/Vulkan: GitHub - vllm-project/vllm-metal: Community maintained hardware plugin for vLLM on Apple Silicon · GitHub. Waarom? Het porten naar MLX is kut
Voor iedereen met interesse in deze materie, dit is een filmpje die het wat mij betreft heel goed uitlegt
YouTube: Cancel Your $200 AI Plan, Buy A $9,499 Mac?

Kijk je naar FP4 dan gaat deze kaart een ~16x meer TFLOPS hebben. (FP16 4x). En ook integer is het verschil groot. (Let op, dit is gebaseerd op verwachtingen van het internet en niet harde data!).
Dus ja je kan een €25k in een lokale 'server' voor je LLM steken. Voordeel is dat je grote modellen een beetje kan draaien, nadeel zal zijn dat tokens / seconde gewoon erg beperkt is, en dus vooral zin heeft voor op de achtergrond wat doen. En ja controle van betalingsgedrag kan natuurlijk prima op de achtergrond.
Maar het grote ding imo: Hoe ga je in hemelsnaam die uitgave goed praten tov gewoon een abbo nemen bij één van de LLM boeren? Je wil het niet naar de cloud sturen? Elk bedrijf stuurt dingen de cloud in, je hebt gewoon een verwerkingsovereenkomst waar precies staat wat er met de data mag gebeuren. Heb je het nou over echt bijzondere data, bijvoorbeeld gezondheidsdata, dan zullen er nog meer eisen zijn. Maar contracten en klantgegevens? Dat is niet zo bijzonder. En zeker niet als we het hebben over MKB bedrijven.

Niet.
Maar soms hoeft dat ook niet. Medische data die niet de [us] cloud in mag. -> lokale LLM!
Bedrijfs geheim? Idem ditto.
Bijna een nieuwe wetenschappelijkle ontdekking. Nobel prijs qualiteit? LLM, en oops, nu is LLM er eerder ondankts dat ze daarvoor 40% van een land zijn onderzoeks budget hebben uitgegeven aan tokens. Maar dat was toeval. Echt!
Conspiracy aside: Sommige dingen wil je *echt* niet publiek. En chatGPT & co betekend publiek.
Specifiek het medische, daar moet beveiliging extra goed gedaan worden. Dus mogelijk kan dat niet naar een (US) cloud. Dus gebruik je een Europese / Nederlandse aanbieder van zulk soort cloud computing voor medische toepassingen. Dat is waarschijnlijk veel veiliger, goedkoper en betere performance dan maar zelf een servertje op je eigen LAN te plaatsen.
Maar goed, zoals ik al schreef, medische data is één ding. Maar bedrijfsgeheimen? Ik werk bij een grote multinational. Meeste van onze data staat allemaal in de cloud. Onze LLMs? Ja de eerste experimenten draaide lokaal want eng, maar tegenwoordig allemaal via de cloud. Als wij als grote multinational waarvan een hoop interessante data te jatten is het al gewoon in de cloud doen, waarom zou het gemiddelde MKB dat niet kunnen?
Als je een enterprise contract hebt met OpenAI, en ze zouden (grootschalig) op die klanten spioneren, dan kan zouden ze de grond in geprocedeerd worden. Dan hoeft daar niemand zich meer druk te maken of AI een bubbel is of niet, hun assets kunnen gebruikt worden om de schadevergoedingen te betalen.Conspiracy aside: Sommige dingen wil je echt niet publiek. En chatGPT & co betekend publiek.


[Reactie gewijzigd door The Zep Man op 15 september 2026 13:32]


Maar inderdaad ongetwijfeld weer een astronomisch bedrag.


OT.. erg benieuwd wat dit allemaal gaat kosten. Ik werk zelf in 3D animatie, waar specifiek VRAM essentiëel is. Laten nou net al die kaarten onbetaalbaar zijn geworden (gelukkig voldoende GPU's voor de prijsverhogingen gekocht).
Hopelijk wordt met een een jaar (of twee) de markt weer wat stabieler, want gpu-rendering workstations bouwen is nu net zo duur geworden als een fatsoenlijke auto kopen.
Uiteraard kunnen renderfarms ingehuurd worden (die ook duurder worden overigens) maar om lokaal projecten op te bouwen zal toch hardware nodig zijn.

[Reactie gewijzigd door ApexAlpha op 15 september 2026 12:58]


Trouwens waar woon jij en welke bloedgroep heb je?

Even serieus; Jeetje wat een specs! Ik weet dat het er niet voor bedoeld is maar ben wel benieuwd naar de game prestaties van dat ding


dat is voor AI, naast de hoeveelheid aan vram de 2de bottleneck.
meer vram = groter model in je geheugen kunnen laden
vram gb/s = hoeveel tokens/seconde je erdoorheen kan jagen.
5090 = 1.79TB/S
5500 = 1.39TB/S
ter vergelijking, van de vorige generatie de echte AI gpu in PCIE formaat:
H200 NVL = 4.89 TB/s


En op welke wijze is het kopen van deze GPUs kosteneffectiever dan het gebruik van compute services in de cloud (e.g. AWS, Lambda Labs etc.)?!

MARKETING: "We plakken twee turbines aan de kont van de kaart en verkopen die voor een godsvermogen!"
JENSEN: "Kijk, daar kan ik een mooi lederen jack voor kopen"

Om te kunnen reageren moet je ingelogd zijn