192GB-mini-pc's met nieuwe AMD-processor kosten rond 8000 dollar
Meerdere merken tonen op de IFA mini-pc's op basis van een AMD Ryzen AI Max+ PRO 495-processor, die maximaal 192GB unified werkgeheugen ondersteunt. Met hun grote hoeveelheid ram zijn de pc'tjes primair bedoeld voor AI-taken.
De AMD Ryzen AI Max+ PRO 495 is het topmodel in de nieuwe Gorgon Halo-serie, de opvolger van de Strix Halo-serie (Ryzen AI Max 300). Deze processor heeft zestien Zen 5-cpu-cores en een krachtige ingebouwde RDNA 3.5-gpu. Deze Radeon RX 8655S heeft veertig compute-units, vergelijkbaar met een losse AMD Radeon RX 7700-videokaart.
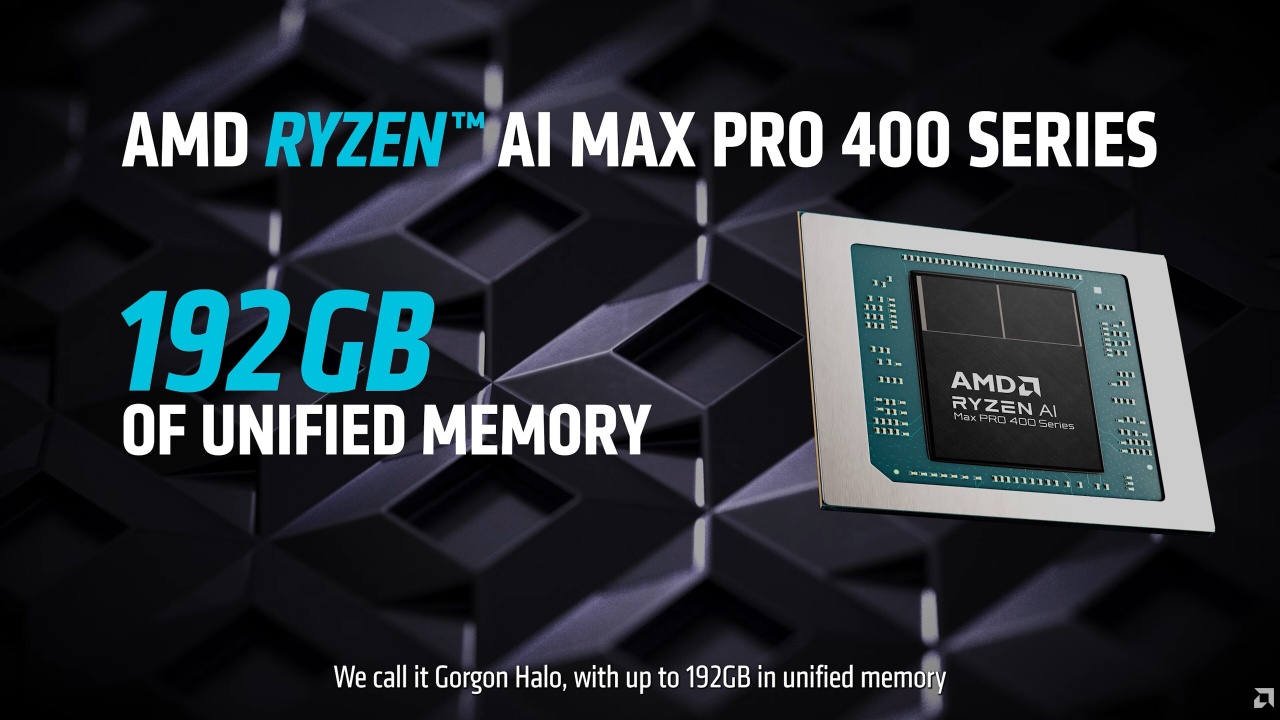
De Gorgon Halo-processors kunnen worden voorzien van maximaal 192 GB ram, waar de Strix Halo-processors nog 128GB ondersteunden. Het gaat daarbij om unified geheugen, dat zowel de cpu als de videokaart kunnen gebruiken. De RX 8655S kan daarbij niet de volledige 192GB aansturen, maar maximaal 160GB.
Voor AI-toepassingen kan zo'n enorme hoeveelheid geheugen wenselijk zijn, bijvoorbeeld om lokale llm's te draaien. Op de IFA presenteren de fabrikanten Acemagic, GMKTec, Lenovo en Minisforum nieuwe mini-pc's voor AI-taken.
Acemagic F9A-Pro495: rgb-verlichting en microfoons
De F9A-Pro495 van Acemagic is een aluminium kastje met een Mac Studio-achtig design en rgb-verlichting. Op het voorpaneel zit een Copilot-knop, maar gebruikers kunnen een AI-assistent ook aanroepen door tegen het kastje te praten. Acemagic heeft vier 360-gradenmicrofoons geïntegreerd in de behuizing. Via ingebouwde 2W-speakers kan de F9A-Pro495 een gesproken antwoord geven.
| Aansluitingen Acemagic F9A-Pro495 | |
| Voorkant | USB4 Type-C (40Gbit/s, DP 2.0 Alt Mode) 2x USB 3.2 Gen 2 Type-A (10Gbit/s) 3,5mm-combi-jack SD-kaartlezer |
| Achterkant | USB4 Type-C (40Gbit/s, DP 2.1 Alt Mode) USB 3.2 Gen 2 Type-A (10Gbit/s) USB 2.0 Type-A HDMI 2.1 DisplayPort 2.1 2x RJ-45-lan (2,5Gbit/s) OCuLink (PCIe 4.0) 3,5mm line-out |
Acemagic heeft een SD-kaartlezer en een DisplayPort-uitgang in zijn systeem gebouwd. Een opvallende toevoeging is de OCuLink-poort. Dit is een externe interface voor het PCI Express-signaal dat we allemaal kennen uit het binnenwerk van een pc. Daarop is een externe videokaart aan te sluiten om de rekenkracht verder te vergroten.


De F9A-Pro495 heeft verder ingebouwde Wi-Fi 7 en Bluetooth 5.4. Er passen twee M.2-ssd's in de behuizing. Het koelsysteem met vijf heatpipes laat de processor op 120W draaien. In de behuizing zit geen voeding, dus er is een externe stroomadapter nodig.
Op 10 september gaat de F9A-Pro495 in de voorverkoop op de website van Acemagic. In oktober komt hij beschikbaar. De verwachte prijs is ongeveer 8000 dollar voor de versie met 192GB werkgeheugen en 8TB opslag.
GMKTec EVO X5-Pro: vingerafdruklezer op het voorpaneel
Net als de pc van Acemagic heeft de GMKTec EVO X5-Pro een metalen behuizing. Die kan zowel verticaal als horizontaal staan. De groene knop op het voorpaneel is niet alleen een aan-uitknop, maar ook een vingerafdrukscanner. Een andere knop op het voorpaneel schakelt tussen powerprofielen. De GMKTec Claw-software moet het gemakkelijk maken om AI-modellen te draaien.
| Aansluitingen GMKTec EVO X5-Pro | |
| Voorkant | 2x USB4 Type-C (80Gbit/s) 2x USB Type-A 3,5mm-combi-jack |
| Achterkant | 2x USB4 Type-C (80Gbit/s) 2x USB Type-A HDMI 2.1 RJ-45-lan (10Gbit/s) RJ-45-lan (2,5Gbit/s) 3,5mm-hoofdtelefoonuitgang |
In de behuizing is ruimte voor drie PCIe Gen4 M.2-2280-ssd's. Drie ventilators en een vaporchamber vormen het koelsysteem, dat 132W aan warmte kan afvoeren. Een externe adapter levert de stroom.
In tegenstelling tot de voorganger, de EVO-X3, heeft de EVO X5-Pro geen OCuLink-poort. In plaats daarvan zijn er vier 80Gbit/s-USB4-poorten aanwezig. Via die aansluitingen kunnen er meerdere EVO X5-Pro's samen in een cluster draaien. De EVO X5-Pro beschikt over ondersteuning voor AMD DASH-technologie, waarmee het systeem op afstand te beheren is. Hiervoor dient de 2,5Gbit/s-ethernetpoort, maar GMKTec heeft er ook nog een snellere 10Gbit/s-poort naast gezet.


GMKTec stelt dat de EVO X5-Pro in oktober beschikbaar zal zijn. Dit Pro-model bevat dan de Ryzen AI Max+ PRO 495-cpu en de volledige 192GB ram die wordt ondersteund. Een prijs noemt de fabrikant nog niet.
Lenovo ThinkCentre X Ultra: minder geheugen en VGA-poort
Tussen kleine merken zoals GMKTec en Acemagic is Lenovo een beetje een vreemde eend in de bijt. De ThinkCentre X Ultra is ook om andere redenen bijzonder. Ondanks de Gorgon Halo-processor is hij niet beschikbaar met 192GB werkgeheugen. In plaats daarvan is 128GB het maximum, waarvan 96GB toe te wijzen is aan de videokaart.


De ThinkCentre X Ultra biedt ruimte aan twee M.2-ssd's. Het pc'tje beschikt over Wi-Fi 7 en Bluetooth 5.4. Net als het systeem van GMKTec is het op afstand te beheren via AMD DASH. Er zijn tot vier systemen aan elkaar te koppelen in een cluster, verbonden via de Thunderbolt 4-poorten.
Opvallend is de 'punch-out port' op het achterpaneel, een verwijderbaar klepje waar een zelfgekozen aansluiting kan worden toegevoegd. Dat kan bijvoorbeeld een tweede 10Gbit/s-ethernetpoort zijn, maar ook nog een klassieke VGA-aansluiting.
| Aansluitingen Lenovo ThinkCentre X Ultra | |
| Voorkant | 2x USB 3.2 Gen 2 Type-A (10Gbit/s) 3,5mm-combi-jack |
| Achterkant | 2x Thunderbolt 4 (40Gbit/s, DP 2.1 Alt Mode) 2x USB 3.2 Gen 2 Type-A (10Gbit/s) HDMI 2.1 DisplayPort 2.1 RJ-45 lan (10Gbit/s) 'Punch-out port' |
Lenovo gaat de ThinkCentre X Ultra vanaf november verkopen voor een startprijs van 3100 euro. Voor dat geld gaat het waarschijnlijk niet om de maximale configuratie met 128GB werkgeheugen.
Minisforum: AI-nas en intern PCIe-slot
Minisforum toont twee verschillende systemen op basis van de Ryzen AI Max+ PRO 495. De N5 MAX zagen we al op Computex. Er past er volgens Minisforum in totaal 200TB aan opslag in. Er zijn vijf 3,5"-bays voor harde schijven. Binnenin zitten vijf M.2-slots met een PCIe 4.0-interface. Slechts een daarvan heeft de volledige vier lanes aan bandbreedte.

De N5 MAX kan draaien op Minisforums eigen Linux-distributie voor zijn nassen, MinisCloud OS. Andere besturingssystemen zoals Windows 11 zijn natuurlijk ook mogelijk. Het kastje heeft een koelsysteem met vijf heatpipes en een ingebouwde 250W-voeding.
| Aansluitingen Minisforum N5 MAX | |
| Voorkant | USB4 Type-C (40Gbit/s, DP 2.0 Alt Mode) USB 3.2 Gen 2 Type-A (10Gbit/s) |
| Achterkant | 2x USB4 Type-C (80Gbit/s, DP 2.0 Alt Mode) USB 3.2 Gen 2 Type-A (10Gbit/s) USB 2.0 Type-A HDMI 2.1 2x RJ-45-lan (10Gbit/s) |
| Intern | USB 3.2 Gen 1 Type-A (5Gbit/s) |
Minisforum zegt dat een N5 MAX met een Ryzen AI Max+ PRO 495 en 192GB ram tussen de 7500 en 8000 dollar zou kosten. Het merk heeft vanwege die prijs geen plannen om hem standaard op zijn website te koop aan te bieden, zoals het bestaande Ryzen AI Max+ 395-model met 128GB ram. Geïnteresseerden kunnen contact opnemen voor de mogelijkheden.
Het andere pc'tje van Minisforum, de MS-S1 MAX, gaat wel in de reguliere verkoop met de nieuwe AMD-processor en 192GB ram. Vanaf oktober moet hij beschikbaar zijn voor naar schatting 8000 dollar. Ook deze pc is niet volledig nieuw. Een versie met Ryzen AI Max+ 395 was al langer beschikbaar.


De MS-S1 MAX kan zowel verticaal als horizontaal staan. In de behuizing zitten twee microfoons om met een AI-assistent te praten. In tegenstelling tot de pc van Acemagic heeft hij geen ingebouwde speakers om iets terug te zeggen.
| Aansluitingen Minisforum MS-S1 MAX | |
| Voorkant | 2x USB4 Type-C (40Gbit/s, DP 2.0 Alt Mode) USB 3.2 Gen 2 Type-A (10Gbit/s) 3,5mm-combi-jack |
| Achterkant | 2x USB4 Type-C (80Gbit/s, DP 2.1 Alt Mode) 2x USB 3.2 Gen 2 Type-A (10Gbit/s) 2x USB 2.0 Type-A HDMI 2.1 2x RJ-45-lan (10Gbit/s) |
| Intern | PCIe x16-slot (PCIe 4.0 x4-bandbreedte) |
De MS-S1 MAX heeft ingebouwde Wi-Fi 7 en Bluetooth 5.4. De behuizing biedt ruimte aan een ingebouwde 320W-voeding, zodat er geen aparte adapter nodig is. Behalve twee M.2-ssd's kan er ook nog een lowprofilekaart in het PCIe-x16-slot. Dat heeft maar vier lanes aan bandbreedte.
06-09-2026 • 14:32
Lees meer


Reacties (81)

Jammer dat het niet in dit artikel staat, dus hierbij: 273 GB/s
Dat wil grofweg zeggen dat een 35b dense model dat 27.3 GB inneemt, slechts 10 output tokens per seconde genereert (zonder eventuele verbeteringen zoals MTP). Zelfs met MoE modellen zal het nog steeds niet comfortabel snel zijn.
Daar kan je dus weinig mee als eindgebruiker.
[Reactie gewijzigd door Jim80 op 6 september 2026 15:49]

Voor grote dense modellen kies je voor snelheid bij voorkeur een dGPU met hoge geheugenbandbreedte en voldoende VRAM. Bij zo’n iGPU met 192 GiB gedeeld geheugen ligt een groot MoE-model juist veel meer voor de hand: veel modelgewichten opslaan, terwijl per token slechts een deel van de experts wordt aangesproken. Dat past veel beter bij deze combinatie van veel geheugencapaciteit en beperktere bandbreedte.
Op mijn Strix Halo haalt Qwen3.8-Flash-Next ongeveer 38 tokens/s, tegenover 8 tokens/s voor Qwen3.8-27B dense, in mijn configuratie. Flash-Next heeft circa 6B actieve parameters per token in het hoofdmodel, tegenover 27B bij de dense variant. De totale modelgrootte door de geheugenbandbreedte delen gaat bij MoE dus gewoon niet op.
“Zelfs met MoE niet comfortabel snel” is daarmee nogal een losse bewering. Ik vind 38 tokens/s prima werkbaar. Hier op Tweakers blijft dezelfde fout terugkomen: een slecht passende modelkeuze gebruiken om de hardware af te serveren.
Een groot dense model op zo’n iGPU kiezen, klagen over de snelheid en daarmee het hele platform afschrijven, vind ik ondeskundig gebruik. Stem je modelkeuze op de hardware af.
Voor snelle generatie met grote dense modellen zou ik een dGPU met hoge geheugenbandbreedte en voldoende VRAM kiezen. Bij deze APU’s met 192 GiB RAM zijn grote MoE-modellen juist logisch: veel geheugen voor alle modelgewichten, terwijl per token slechts een deel actief is. AMD beschrijft dat voordeel zelf ook.
Op mijn Strix Halo haal ik met mijn instellingen ongeveer:
Qwen3.8-Flash-Next MoE: 38 t/s.
Qwen3.8-27B dense: 8 t/s.
En Flash-Next heeft 125 miljard parameters in het hoofdmodel. Tel de 51 miljard aan n-gram embeddings en 4 miljard voor MTP mee en je komt op circa 180 miljard parameters. Van het hoofdmodel zijn per token slechts 6 miljard actief, tegenover 27 miljard bij de dense variant.
Dus een veel groter model draait op dezelfde iGPU bijna vijf keer zo snel. Je uitspraak dat zelfs MoE “niet comfortabel snel” zou draaien, wordt door die dense-rekensom nergens onderbouwd. Een onhandige modelkeuze verheffen tot een tekortkoming van het hele platform is wel erg makkelijk.
[Reactie gewijzigd door Emielio op 6 september 2026 23:12]

De MS-S1 MAX+ 395 draait standaard op windows 11 en heeft daar 96GB geheugen beschikbaar voor het laden van LLM's. Vanuit Ubuntu is het mogelijk om zelf aan te geven hoeveel geheugen er beschikbaar is voor de LLM's, en heb die van mij ingesteld op 115 GB voor LLM's. Helaas staat in het artikel niet vermeld met welk besturingssysteem het 495 model wordt geleverd, mogelijk zit er nog rek in als deze ook met Windows wordt geleverd

Als de prijs verdubbeld word zou je 256Gb verwachten en niet 192GB. En dat houd dan nog geen rekening met de kost van de cpu/gpu van de strixhalo

het antwoord zonder electriciteit waste... computer technologie kennis


Maar het voelt als een echte ick, net als wanneer je een auto wil kopen die een beetje vlot is, maar vervolgens de verkoper het alleen maar heeft over de topsnelheid, en zwijgt over de acceleratie, en wanneer je t vervolgens zelf opzoekt, je er dan achter komt dat de 0-100 13 seconden in beslag neemt.
In de praktijk denk ik dat als je een beetje een vlotte ervaring wil met local LLMs, je een memory bandwidth van tenminste 1 TB/s wil hebben, en idealiter nog meer dan dat.
Met minder kan je duidelijk werken, in de zin dat t geheel dan niet crash oid, aangenomen dat het geheugen genoeg capaciteit heeft. Maar er is dus die grens waaronder het geheel gewoon te traag is voor alles behalve de meest triviale dingen, en dit wordt alleen maar uitvergroot op t moment dat agentic workloads hierbij komen kijken.
[Reactie gewijzigd door Jeanpaul145 op 7 september 2026 01:36]
Naarnaast is 192GB (~180GB) VRAM op een hoge snelheid op een enkele kaart natuurlijk absoluut niet realistisch voor $8k. En H200 (141GB) of een B300 (288GB) kost heel, heel veel meer.
Zelfs tegenover oude ram prijzen zouden dit mijn inziens omdat het kan machines zijn niet omdat het nuttig is, met deze prijzen is het volstrekt kansloos.
De nieuwe M5 Ultra met 80 core GPU, 512GB unified memory en 16TB aan storage zal zo rond de €25k+ zijn gok ik... En als je met 1TB storage genoegen neemt zal het nog steeds €17k+ zijn...
GPU, RAM en storage zijn momenteel heel veel geld en of je die prijzen betaald hangt heel veel af van wat je ermee doet en wat het oplevert. Ik denk zo dat de hobbyisten afhaken, maar dat iemand die er geld mee verdient gaat kijken hoeveel hij/zij ermee kan verdienen en of zo een uitgave een goede investering is (met alle risico's).
Zelfs de mensen die bezig zijn met LLMs zie ik vaak grijpen naar oudere, goedkopere, 2e hands oplossingen en niet de super snelle, perper dure, cutting edge hardware.
Als men echter professioneel (zakelijk) bezig is met data die niet de deur uit kan/mag, dan heb je weinig andere keuze.
ja je mist wat geheugen maar zelfs de instapper heeft al bijna de dubbele memory bandwidth.
en dat lijkt kwa prijs al gunstiger.
[Reactie gewijzigd door Gerwinnn op 6 september 2026 20:54]
Ja, een M5 Max 128GB is goedkoper (~€6k) maar heeft slechts 2/3e van de geheugen capaciteit. En als je aan 128GB genoeg hebt (model + context) is een M5 Max 128 ook een goedkopere en veel snellere keuze (273GB/s vs 614GB/s). Right tool for the job... En een Ultra is weer eens 2x zo snel, een M5 Ultra met 256GB is €11k+, als je het geld hebt en je gebruikt het, waarom niet. Maar dit is imho alleen onder heel specifieke omstandigheden interessant en het gros van ons zit daar niet aan.

Niet dat ik dit soort hardware ga kopen. Het is morgen verouderd en veel te duur voor wat je krijgt. Een auto van die prijs rijd nog 10 jaar rond. Dit ding kan je over een half jaar niets meer mee
Ik snap de hype rondom lokaal draaien ook niet zo. Waarom 8000 euro voor zo'n systeem betalen, terwijl je voor 200 euro per maand de allerlaatste modellen kan je gebruiken met een veel hogere snelheid, en parallel kan draaien met meerdere agents. Dat is 8000/200 ~ 3 jaar. 1 ding is zeker, dan is er weer nieuwere snellere hardware.
Natuurlijk als privacy super belangrijk is liggen de prijzen anders maar dan koop je niet z'n traag 10 tokens per sec apparaat dat is onwerkbaar.

Maar... het is geen Astra of Fable. Je zult er meer tijd en energie in moeten steken om dezelfde resultaten te halen. De 3 modellen die ik noemde zitten tegen de absolute frontier aan van een maand of 6 geleden. Dat is eigenlijk waanzinnig.
Die open weight modellen blijven zich ook ontwikkelen in een rap tempo, dus als we een jaar verder zijn, wie weet wat we dan op zo'n apparaat kunnen draaien? Maar 8.000 Euro blijft wel een enorm bedrag...
En dit blijft natuurlijk een apparaatje voor de Tweaker - daar is helemaal niks mis mee, maar voor het gemiddelde huishouden is dit nog veel te ingewikkeld, nog buiten dat het een godsvermogen kost.
[Reactie gewijzigd door dreamtheater42 op 6 september 2026 20:28]

Waarvoor is die Oculink handig, voor als je een 5090 hebt liggen en net iets meer tokens per seconde wilt halen? Maar dan heb je weer niets aan die 160GB unified RAM.


 . Dat zal vast nog wat sneller kunnen met wat truukjes. Op een enkele DGX Spark met de ngram tables op storage haal je ongeveer 25-30 tokens/s.

Please share!...het meest gedetailleerde antwoord dat ik ooit heb gezien op mijn vraag waarom de bananen krom zijn

Ik heb hier laatst wat over nagedacht en kwam tot de conclusie dat het toch nog niet zover is om echt een groot model makkelijk zelf te draaien. Denk echt dat je beter een kleiner goed model op full precision kan draaien dan groter die een beetje gehandicapt is.
15 t/s met veel betere quant en meer context zou echt al super chill zijn, maar daar gaat nog MTP/Dspark bovenop komen.
Oh en, wat met lemonade ook heel goed kan, meerdere modellen tegelijk draaien. Niet allemaal tegelijk snel inference draaien, maar om en om kan heel nuttig zijn voor bepaalde flows, en parallel kan afaik ook.
Het belangrijkste was dat er nooit uitval is. Niet alleen vanwege de kopzorgen je krijgt dan een architect die honderden per uur kan kosten, die IT troubleshooting gaat doen.
En daarnaast moet het zo snel mogelijk zijn.
5% sneller klaar zijn met het doorrekenen, kan het verschil zijn tussen door kunnen werken of toch geneigd zijn even koffie te gaan halen terwijl de PC aan het rekenen is.
Architecten die koffie gingen halen was bij het management echt een probleem wanneer het druk was.
Dus ja, 8 duizend voor een PC klinkt misschien veel, maar een werknemer kost aanzienlijk veel meer.

Vaak lees je reacties dat het zo duur is, maar dat hangt echt van de usecase af.
Prive zou ik nooit dit ding voor €8000 kopen. Echter zoals je zelf al aangeeft, zakelijk, als het dus bespaard of oplevert is het een no-brainer en simpele koop. Desnoods koop je er 2 of 3. Plus zakelijke aankoop kost dit ding al aanzienlijk minder als je de btw eraf trekt en de ‘kosten’ rekent die de zaak maakt. Prive is gewoon duur. Dan moet het wel een hele grote hobby zijn, of als je een zeer dikke portomonee hebt (of voor Gen Z en hoger: hoog saldo)


Ah de prijzen voor een R6000 zijn verdubbeld sinds de zomer. uitvoering: Nvidia RTX PRO 6000 Blackwell Workstation bulk deze is 96GiB. Dus daar wil je er twee van hebben. Zit je op 32k alleen voor de kaarten.
Dus een machine als deze gebruiken voor taken die wel een grote context nodig hebben maar niet per de snelheid is zo gek nog niet.
Voor een beetje meer dan het geld van deze Strix heb je een instap Mac Studio met meer geheugen (256gib) en een dubbele bandbreedte.
[Reactie gewijzigd door Spockz op 6 september 2026 17:27]
Mistral is het gewoon lang niet.
Maar als ik voor mijn werk nu voor 8000 euro ChatGPT niveau werk zou kunnen leveren (businesscases opleveren voor de bank bijv.) dan zou ik zelfs soort van Prive het die 8k wel waard vinden.
Wat een mooie techniek is het geworden.
Het gaat helemaal niets besparen zolang je appels met appels vergelijkt. Pak er stroom en koelingskosten bij en zelfs als je het 24/7 draait, zal een oplossing met hetzelfde model in de cloud altijd goedkoper zijn. Het probleem is scaling!...als het dus bespaard...
Nee, dit gebruik je als je niet wil of het niet mag dat je data door een andere partij wordt verwerkt. En die situaties zijn relatief zeldzaam.
BTW aftrek is leuk, en zeker als het onder de kleine ondernemersaftrek regeling valt, maar het kost nog steeds geld, ook heeft het na aftrek nog een restwaarde. Het is allemaal niet zo eenvoudig. Zelfs al zou het je maar €3200 kosten, ook de cloud kosten zijn geheel aftrekbaar (inc. btw aftrek), maar direct aftrekbaar ipv. over 5 jaar.
Ik krijg niet meer dan 8cpu/32GB ondanks dat die machine constant gemaxed is en ik dan maar koffie ga halen. Verkeerde zuinigheid natuurlijk.
Meer productiviteit en als bonus ook nog een meer tevreden werknemer.
Doe ons een voorstel voor x laptops voor kantoorgebruiker en x aantal voor een software ontwikkelaar.
Niet exact vermelden wat specifiek nodig is en daarna voor de goedkoopste gaan.

nieuws: AMD Ryzen AI Max Pro 400-cpu's krijgen maximaal 192GB geïntegreerd werkgeheugen
Kun je beter investeren in een macstudio, die heeft grofweg 600GB voor de M5 max en 1200GB voor de M5 ultra. Dit toestel levert ongeveer de helft 300GB. Zo mac studio is dus 2 tot 4 maal sneller maar hoe groter het model hoe trager.
zelfs een macstudio gaat met een model zoals die van deepseek v4 maar een 30/50 tokens per seconde afleveren en dan heb je dus een veel kleiner model dat bijlange na niet zo goed is als opus 4.8
Ik zou dus indien je geen “privacy” redenen hebt gewoon met de online modellen blijven verderwerken
Deze persoon op youtube test regelmatig grote modellen.
YouTube: I Gave Local AI and the Cloud the Exact Same Job
[Reactie gewijzigd door klakkie.57th op 6 september 2026 19:09]
Ergens hoop ik op een dag een keer zoiets lokaal of op een eigen server te kunnen draaien, zodat je niet meer afhankelijk bent van de VS en zelf over de techniek te kunnen beschikken.


Dat is meer een watervaleffect. Doordat AI alle productiecapaciteit van SSD's opslurpt vallen meer "traditionele" sectoren weer meer terug op HDD's. Datacenters die tot vorig jaar nog al hun hosting en applicatieservers volledig met SSD's inkochten, vallen nu door hoge prijzen en tekorten terug op HDD's. HDD fabrikanten op hun beurt hadden tot vorig jaar te maken met afnemende vraag vanwege de verschuiving naar SSD's, maar die vraag neemt nu dus weer sterk toe. Ik heb geen cijfers in hoeverre de productiecapaciteit voor HDD's de afgelopen jaren ook is teruggeschaald, maar door een explosieve groei in de vraag kan men gewoon meer vragen voor de producten.…kwam gister achter, … dat zelfs simpele hdds 2x zo duur zijn nu als dat ze bv 8 jaar geleden waren, en ik geloof nooit dat die trage hdds geschikt zijn voor een doorsnee ai systeem, dus dat het door AI komt geloof ik niet echt).


Om te kunnen reageren moet je ingelogd zijn