Nvidia: RTX Spark-laptops zijn vanaf oktober beschikbaar
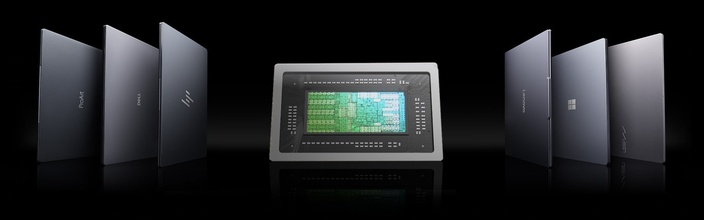
Op IFA maakt Nvidia officieel bekend dat laptops en pc's met zijn RTX Spark N1X-chips vanaf oktober in de winkels liggen. De Spark N1X komt in eerste instantie beschikbaar in twee varianten, die verschillen in coreconfiguratie en hoeveelheid ram.
Nvidia maakte de RTX Spark N1X voor het eerst wereldkundig op Computex in juni, maar deelt nu meer details. De N1X komt uit in twee varianten, die beide hetzelfde heten. De snelste heeft, zoals eerder bekend werd, een Nvidia Blackwell-gpu met 6144 CUDA-cores en een 20-core-cpu van MediaTek.
De tragere N1X-variant beschikt over 5120 CUDA-cores en een 18-core-cpu. Nvidia zegt niets over tragere RTX Spark-chips met 12 of 10 cpu-cores en minder gpu-cores, die MediaTek eerder aan Tweakers bevestigde.
| Processor | Cpu | Gpu (Blackwell) | Geheugen | Apparaten |
|---|---|---|---|---|
| Nvidia RTX Spark N1X | Grace (20 Arm-cores) | 6144 CUDA-cores | 24-128GB Lpddr5X |
Laptops en desktops |
| Nvidia RTX Spark N1X | Grace (18 Arm-cores) | 5120 CUDA-cores | 24-32GB Lpddr5X |
Laptops |
Naast de coreconfiguratie verschilt ook de maximale hoeveelheid werkgeheugen. Het gaat daarbij om unified ram, dat toegankelijk is voor zowel de cpu als de gpu. De snelste N1X is voorzien van 24GB tot 128GB werkgeheugen. De tragere variant heeft 24GB of 32GB aan boord.

Volgens Nvidia is ook het 'instapmodel' met 24GB geschikt om lokaal AI-modellen en -agents op een laptop te draaien. Gamen kan ook. Op gamescom kondigden game-uitgevers EA en Embark vorige week aan hun anticheatsoftware geschikt te maken. Ook Ubisoft maakt zijn spellen geschikt voor RTX Spark.
Eerste modellen in oktober
De snellere N1X komt in zowel laptops als compacte desktop-pc's terecht. Het tragere model is alleen in laptops verkrijgbaar. Op Computex werden daarvan al meerdere aangekondigd. Op IFA kwamen daar nog een paar modellen bij: de Acer SFF RTX Spark-mini-pc en de Lenovo Yoga 9n 2-in-1-Gen 11-convertible.
Eerder zei Nvidia al dat de eerste RTX Spark-apparaten in de herfst beschikbaar zouden zijn. De fabrikant zegt nu specifiek dat ze vanaf oktober uitkomen. Nvidia houdt nog wel een slag om de arm, omdat de beschikbaarheid per regio kan verschillen.
04-09-2026 • 16:14
Lees meer


Reacties (14)

Apple gebruikt met de M-serie al jaren unified memory en nu komt er een windows alternatief bij die lokaal grote LLM's kan draaien (AMD had die ook al, maar ARM heeft qua efficiëntie meer toekomst).
Nvidia zit straks goed gepositioneerd in beide markten, Ben benieuwd of Intel tijdig kan aanhaken...
Hoop stiekem op high-end (ARM) APU met unified memory die Linux draait, ben als Windows gebruiker eens aan het experimenten op oude laptop en wil graag wat meer loskomen van Big Tech (ben waarschijnlijk niet de enige).
Ze zijn recent weer begonnen met eigen RAM maken van wat ik me herinner

Deze chiplet bestaat een meerdere stukjes silicium van verschillende wafers die samen in 1 package samengesteld worden en eruit zien als 1 chip. Omdat alles zo dicht op elkaar zit in 1 beschermde package zijn verbindingen en geheugen bandbreedte veel sneller, met lagere spanningen en dus zuiniger.
Ik verwacht wel dat er op middellange termijn meer devices uitkomen met een lokale mini LLM zoals Needle, maar waar de gebruiker niet direct mee chat
Ik heb er zelf weinig ervaring mee, al probeer ik afgelopen tijd meer in te verdiepen. Naast dat het beetje (wie heeft de grootste/dikste) p-vergelijkingen zijn, qua hoeveel gpu en/of ram mensen hebben, lijkt vooral of lokaal ai kleinschalig wordt gebruikt of mix van lokaal en cloud.
Maar goed, de ene groep zegt “meer snelheid” vs de andere groep “meer ram”, terwijl ik meer voor de bang for buck ben gegaan met een 9060 XT.

Het lijkt erop dat het dadelijk weer allemaal wat kleiner kan of dat er minder compromissen gemaakt hoeven te worden voor de wat kleinere laptops mbt kracht/koeling.
Dat dacht ik overigens ook met de SoC's van AMD, waarschijnlijk zullen deze ook wel niet bepaald mainstream worden.

 .


Pas vorig jaar heb ik normale desktops met Zen 2 processoren gebouwd en pas dit jaar ben ik overgegaan op Snapdragon X voor mijn laptop en mini-PC. Dat is ruim 2 jaar na het uitkomen van de eerste systemen met deze chips.

Om te kunnen reageren moet je ingelogd zijn