OpenAI brengt GPT-6 Astra uit en suggereert dat het 'agi' is
OpenAI heeft GPT-6 Astra geïntroduceerd. Dat model komt op donderdag beschikbaar voor een aantal geselecteerde bedrijven. Binnenkort volgt een versie voor betalende ChatGPT-gebruikers. Tijdens een persbriefing wekte OpenAI de suggestie dat Astra 'agi' is, al is dat een vage term zonder duidelijke betekenis.
Dit nieuws in het kort
- OpenAI introduceert GPT-6 Astra, zijn krachtigste AI-model tot nu toe.
- Het bedrijf zegt dat Astra aanzienlijk beter is in het aansturen van AI-agents, programmeren en het opstellen van documenten en spreadsheets.
- OpenAI suggereerde tegenover journalisten dat met Astra 'het agi-tijdperk is aangebroken', al is de definitie van agi nogal vaag.
- Astra komt per direct beschikbaar voor OpenAI Daybreak-leden. Over enkele dagen volgt een release voor gebruikers met een ChatGPT-abonnement.
OpenAI deed de aankondiging in een briefing met verschillende Amerikaanse media, waaronder The Verge, WIRED, TechCrunch en Bloomberg. In hun artikelen citeren die media een blogpost van OpenAI, maar die staat op het moment van schrijven nog niet online.
Astra kan AI-agents beter aansturen
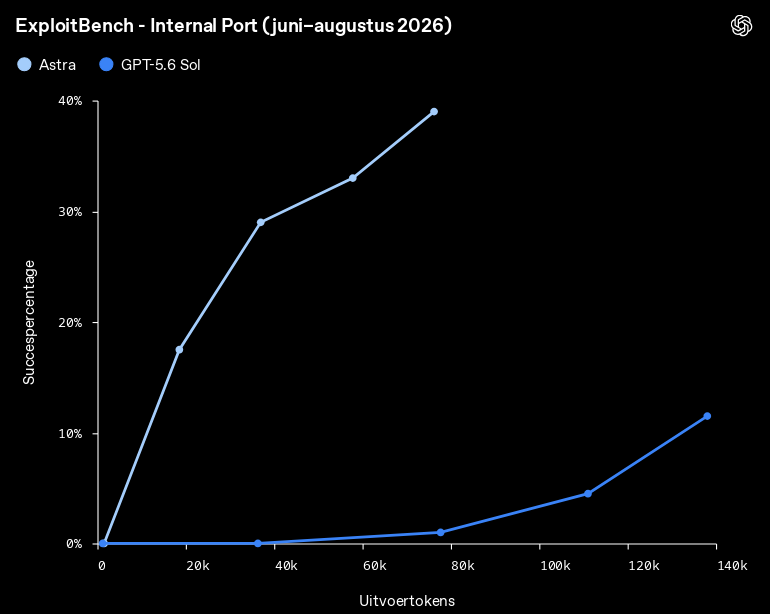
De modelbouwer noemt GPT-6 Astra een grote stap vooruit. Het model moet aanzienlijk beter presteren en meer taken kunnen uitvoeren dan OpenAI's huidige frontiermodel, GPT-5.6 Sol. Het bedrijf benadrukt daarbij vooral het gebruik van AI-agents.
Astra kan computers en webbrowsers veel beter bedienen dan zijn voorgangers, claimt het bedrijf tegenover journalisten. Het model kan 'sneller afspraken boeken, vacatures zoeken en appartementen vinden dan de meeste mensen', beweert de AI-maker.
Het model is volgens OpenAI ook in staat om zelfstandig werkende websites te bouwen en 'opgepoetste' documenten, spreadsheets en presentaties te maken. De media die nu over Astra schrijven, delen overigens geen concrete benchmarkresultaten of andere bewijsstukken.
Betere vangrails
Volgens OpenAI is Astra ook een stuk beter afgekaderd met vangrails. Het bedrijf stelde de release eerder al uit om meer veiligheidsmaatregelen toe te voegen. Begin augustus zei OpenAI dat de ontwikkeling van Astra was stilgelegd vanwege zijn hackvaardigheden.
Het bedrijf deelde onlangs al informatie over de release van Astra en zijn aanpak daarvan. De versie die algemeen beschikbaar komt, is volgens de AI-maker voldoende afgeschermd om misbruik te voorkomen. Bij jailbreakpogingen zou Astra veel beter in staat zijn om die te weigeren dan GPT-5.6 Sol.
OpenAI zegt dat 'het agi-tijdperk' is aangebroken
Met de release van GPT-6 Astra zou 'het agi-tijdperk' zijn aangebroken, suggereerde OpenAI-president Greg Brockman tegen journalisten. "Als we over een paar jaar terugkijken en ons afvragen: 'Wanneer is agi eigenlijk ontstaan?', dan denk ik dat het rond deze tijd zal zijn, en ik denk dat het misschien wel om dit model gaat", aldus de topman.
De term agi, ook wel artificial general intelligence, is een onderwerp van discussie in de AI-sector. Het moet een AI-systeem omschrijven dat de intelligentie van een mens kan evenaren of voorbijstreven. Tegelijkertijd is het een behoorlijk vage term. Er is geen eenduidige definitie van agi; AI-makers verzinnen zelf wanneer ze dat bereikt zouden hebben.
Eerst voor Daybreak-leden, dan naar abonnees
GPT-6 Astra komt vanaf vandaag beschikbaar voor een beperkt aantal enterprisegebruikers. OpenAI beperkt die eerste release namelijk tot leden van zijn Daybreak-programma. Binnen dat programma krijgen sommige bedrijven en securityexperts toegang tot geavanceerde AI-modellen om kwetsbaarheden in hun software te vinden.
In de komende dagen volgt een algemene release voor betalende ChatGPT-gebruikers. Die versie wordt minder hackvaardig dan het model dat Daybreak-leden krijgen. Of Astra op termijn ook beschikbaar komt voor ChatGPT-gebruikers die niet betalen, is niet bekend.

03-09-2026 • 20:59
Lees meer


Reacties (184)
En voor AGI zitten we met LLM überhaupt gewoon volledig op het verkeerde pad.

Net zoals bij mensen zijn ze multimodaal (beeld/audio/video/code) en hebben ze nu een chain-of-thought in plaats van louter patroonherkenning. Daarbij kunnen AI Agents in plaats van passief te antwoorden veel meer handelingen zelfstandig uitvoeren. Het lijkt steeds meer op een brein.
Nog ver van AGI, wat natuurlijk een buzzwoord is om makkelijker in het nieuws te geraken.
Veel LLM's produceren betere output als ze eerst een heel opstel voor zichzelf schrijven, maar dat principe kon je ook wel toepassen op oude LLM's. Nog steeds helpt het een LLM te vertellen zijn antwoord nog een keer te controleren voor het zijn conclusie schrijft, of als je met buzzwords wil gaan gooien kun je "agents" inzetten die elkaar tekst voeren tot de magische tokens eruit komen die consensus betekenen.
Meer context window en snellere verwerking zorgen ervoor dat het lijkt alsof er veel meer speciaal gebeurt dan wat er daadwerkelijk plaatsvindt. Het is niet alsof het algoritme zozeer veranderd is, alleen de LLM kan nu in ongeveer dezelfde tijd een heel verhaal tegen zichzelf ophangen en daardoor minder verkeerde output genereren.
Nog steeds zijn LLM's louter patroonherkenning, maar deze patroonherkenning is nu veel effectiever toegepast dan toen ze voor het eerst de markt op kwamen.
Even los van alles, volg ik de conclusie van deze zin niet. Als je als mens tijdens een gresprek "nadenkt vooraleer te spreken", is dat in essentie toch nagenoeg hetzelfde als "even tegen jezelf praten zonder dit hardop uit te spreken naar de ander"?De "chain of thought" is de LLM instruëren tegen zichzelf te praten, en het stukje tegen zichzelf praten te verbergen van de eindgebruiker. Dat is niet echt menselijk,
Filosofisch gesproken denk ik dat LLM's juist hierom (wellicht perongeluk) zo'n schot in de roos zijn kwa emuleren van communicatie tussen mensen. Namelijk dat wij zelf eigenlijk niks anders doen dan 'het beste volgende woord zoeken' bij het formuleren van spraak. En als ik ergens over nadenken, doe ik niet anders dan tegen mezelf praten in het koppie om allerlei opties langs te lopen.
[Reactie gewijzigd door Boxman op 3 september 2026 22:26]
Hoe erg het denkproces van een mens op een LLM lijkt, zal enorm verschillen tussen mensen. Sommige mensen hebben een actieve interne monoloog, andere mensen juist bijna niet. Sommige mensen hebben diverse interne monologen die met elkaar in gesprek gaan, anderen hebben één stroom aan gedachten.
Het zou kunnen zijn dat jouw interne denkproces veel meer lijkt op de output van een LLM dan de mijne, maar ik vind het veel te ver gaan om die twee met elkaar te vergelijken. Zowel op mechanisch vlak als procesvlak verschillen mensen en LLM's van elkaar. Zoals je zelf schrijft: een LLM kan communicatie emuleren.
Vanuit een filosofisch oogpunt verwacht ik dat AGI ooit daadwerkelijk mogelijk zal zijn, maar ik verwacht niet dat deze GPT's daar de basis voor zullen zijn.
Maar concepten als "begrijpen" blijven een relatief begrip. Een LLM 'weet' waar die het over heeft omdat hij een enorme bak context heeft. Maar ik vind je 'rood' voorbeeld wel een leuke - hoe weten wij eigenlijk kwat het concept 'rood' beekent? Hebben we daar echt een fundamrnteel diep inherent begrip van, of weten wij enkel wat 'rood' inhoudt omdat onze ouders en omgeving ons talloze voorbeelden heeft laten zien van 'rode' dingen?
Met dat laatste lijkt het er toch sterk op dat ook het menselijk brein voor een heel groot deel uit een bibliotheek van context opereert.
Wat ik wel interessant vind om te weten; als jij aan het formuleren van een zin begint, gaat dat dan in essentie woord-voor-woord, of weet jij in 1 instantie de gehele zin (en dus in principe gelijktijdig het eerste en laatste woord)
Als ik een gedachte wil formuleren, weet ik wanneer ik aan een zin begin in ieder geval zeker nog nietnmet welk woord die gaat eindigen.

Een beetje van beide: aan de ene kant hebben we in dit voorbeeld kegeltjes en staafjes in onze ogen waarmee we kunnen abstraheren naar qualia: de subjectieve ervaring van in dit geval het zien van een eigenschap van een object. Een eigenschap dat wij als mensen vervolgens verder abstraheren met het label rood.Maar ik vind je 'rood' voorbeeld wel een leuke - hoe weten wij eigenlijk kwat het concept 'rood' beekent? Hebben we daar echt een fundamrnteel diep inherent begrip van, of weten wij enkel wat 'rood' inhoudt omdat onze ouders en omgeving ons talloze voorbeelden heeft laten zien van 'rode' dingen?
Dat label zelf is vrij arbitrair natuurlijk (immers, red in t Engels of rojo in t Spaans refereren naar diezelfde abstractie met een ander label), maar het concept en de qualia erachter niet.
Dus als je met je vraag doelt op het concept van rood, dat ontdekken we op individueel niveau obv herhaaldelijke blootstelling aan de qualia, natuurlijk uitgezonderd mensen die überhaupt niet kunnen waarnemen bv (kleuren)blinden of mensen in een coma.
Maar het sociale contract om daar een (goeddeels) consistent label op te plakken, dat is iets dat in de sociale wereld leeft en dus vrijwel volledig wordt meegegeven aan een individu wanneer ze nog een klein kind zijn.
LLMs kunnen dat laatste stukje (de semantiek) herkennen alsmede het visuele patroon in bv foto's of videos, maar nemen in elk geval op dit moment niet de qualia waar zoals mensen dit doen.
Dat lijkt er niet alleen op, dat is ook zo. Het is bijvoorbeeld waarom je naar een lepel reikt wanneer je een lekker soepje wil eten, maar naar een mes en vork zoekt als je op t punt staat een steak te eten.Met dat laatste lijkt het er toch sterk op dat ook het menselijk brein voor een heel groot deel uit een bibliotheek van context opereert.
En het is ook waarom je sommige muzieknummers in een genre prachtig vindt en andere nummers in datzelfde genre niet kan uitstaan.
Of bijvoorbeeld hoe we omgaan met voorrang tijdens het autorijden: zie je haaientanden voor je op de weg of het neerpuntse driehoekabord, dan is t voorrang verlenen. Maar zie je ze niet heb je meer beslissingen te maken. Dus de context van de haaientanden of het bord in een gegeven situatie bepaalt mede wat er verder gebeurt.
Dit is een interessante - bij mij is dat soms wel en soms niet het geval. Ik begrijp je punt hier, in t laatste geval begint het idd meer op contextuele woordvoorspelling te lijken.Wat ik wel interessant vind om te weten; als jij aan het formuleren van een zin begint, gaat dat dan in essentie woord-voor-woord, of weet jij in 1 instantie de gehele zin (en dus in principe gelijktijdig het eerste en laatste woord)
Als ik een gedachte wil formuleren, weet ik wanneer ik aan een zin begin in ieder geval zeker nog nietnmet welk woord die gaat eindigen
Maar zelfs daar kan er een groot verschil zijn: ik vermoed sterk dat mensen dat niet woord voor woord doen, maar meer lateraal te werk gaan, in de zin dat we conceptueel werken, en gegeven die context + wat er eerder is gezegd + wat de intentie is om te communiceren, er maar zoveel woorden zijn die passen om de zin mee te vervolgen. Dus het uiteindelijke effect is om impliciet een relatief kleine lijst aan kandidaten op te bouwen waarmee een zin vervolgd zou kunnen worden zodanig dat de intentie wordt uitgedrukt. Dat helpt snelheid, maar ook precisie en accuratesse.
Dus wat mensen doen is niet helemaal hetzelfde als wat LLMs doen (want die voorspellen woord voor woord en houden vziw niet expliciet rekening met hun eigen intentie, en met name het seriële woord-voor-woord verwerken is 1 grote reden dat er veel onderzoek gedaan wordt naar Diffusion modellen voor voorspelling, wat meer parallel kan werken maar z'n eigen problemen heeft), maar wel op een hoog niveau vergelijkbaar.
Tja vraag om een grappige rijm over thema x en dat komt sneller en beter naar voren dan 90% van de mensheid kan produceren.Het mooie aan mensen is dus juist dat ze onverwacht uit de hoek kunnen komen , satire bijvoorbeeld of kunst die niet zinnig lijkt . Dus doen alsof wij alleen maar het beste volgende woord produceren is echt onzin .
Die AI's spuwen dingen uit die voor sommige individuen als nieuw omschreven wordt, maar dat is alleen omdat ze niet alles kunnen weten. Dat een AI zelf iets nieuw ontdekt moet nog gebeuren.
Nou, filosofisch converseren is aan jou in ieder geval niet besteed zo te zien😂Dus doen alsof wij alleen maar het beste volgende woord produceren is echt onzin .
ga je ai thuis draaien dan zie dat er nul inhoudelijke verschil zit tussen chain of thought aan of uit. Geloof me het is het eerste wat je uit zet. Het enkele nutteloze context vram ruimte en vertraagt he output snelheid enorm.
[Reactie gewijzigd door xbeam op 4 september 2026 00:39]


Edit: waarom down vote? Ben ik de enige die de bewering overdreven vind?
[Reactie gewijzigd door sebastienbo op 5 september 2026 11:27]
Menselijk brein (1 minuut nadenken/typen) = 0,33 Wh
Standaard chatbot (bijv. GPT-4o / Gemini) = 0,2 tot 3 Wh (1 tot 9x meer)
Redenerend AI-model (bijv. OpenAI o1 / DeepSeek-R1) = 7 tot 23 Wh (21x tot 70x meer)
Tegenwoordig zijn zelf die values vele keren lager geworden. Het perfect voorbeeld is local AI modellen die GPT 4o ver ver overstijgen en gewoon op een gsm kunnen draaien.
Met qwen 3.6 35B 3A zit je zelf al op opus 4.5 en chatgpt 5 kwaliteit dat gewoon op een laptop draait.
En als je bijna Opus 4.8 kwaliteit wil kan je qwen 3.8 27b downloaden een op je laptop draaien.
De tijd dat je kan zeggen dat AI energie verslurpt is dankzij de chinezen al lang verleden tijd. Om de zoveel tijd komt er een nieuwe techniek dat er nog minder power nodig is (denk aan MOE of MTP of quantisation). Daarnaast word de hardware ook geoptimaliseerd voor inference. Ik heb een ARM V2 laptop waar elke core speciale matrix calculators heeft (duidelijk voor inference bedoeld).
[Reactie gewijzigd door sebastienbo op 5 september 2026 10:55]
En daar draait genoeg productie workloads op met AI / LLM
Sterker nog, mijn hele serverrack met o.a. 5 servers waaronder een RTX 5090 piekt op iets boven de 900W
En daar zit dan ook nog mijn NAS op met 4 HDD's, netwerk apparatuur, camera's etc etc.
En die 900W piek is bij het genereren van AI video's.
En daar wordt echt genoeg AI / LLM op gedraaid, van image / video gen tot aan coding / research tasks.
Het trainen van die modellen kost wel veel stroom, maar dat kan je verdelen over de miljoenen mensen die het model gebruiken. Per vraag die je stelt is dat echt verwaarloosbaar.
Het resultaat is verbazingwekkend goed. Ik heb Rust windows gui system tray apps geschreven zondef een regel code aan te raken, en ik ben momenteel bezig met een 25k regels C++ code base from scratch. Hij doet vrijwel alles zelf, wel wat design guidance nodig.
Maar dit is dus een volledig "gratis" en prive setup, geen enkele data leakage, imternet kan unplugged. Nou is een 5090 bemachtigen tegenwoordig natuurlijk wel een dingetje
 Op een 16GB kaart kan je denk ik wel net Q4 quants draaien; die zullen het ook behoorlijk goed doen nog.
[Reactie gewijzigd door Zoijar op 4 september 2026 09:21]
Mag ik ook nog vragen waarom je dit gebruikt, in plaats van bv Claude Code of Codex? Gaat het jou om het 'gratis' of de vooral om de privacy? Of gewoon omdat het leuk is om zo met technologie te spelen (we blijven immers tweakers.. :-) )

Als ik nu kijk naar dit kleine hobby projectje dusver, zo'n 25k regels, dat zou naar schatting zo'n $200 aan tokens zijn met Claude Fable. Dat vind ik best veel voor iets dat gewoon voor de leuk is. Natuurlijk kost een 5090 ook 5k euro, maar als ik dus 10 maanden per jaar zo hobby programmeer dan heb je die na 2.5 jaar gratis. Tussentijds kan ik ook heerlijk gamen en andere dingen doen met een top-end GPU, en waarschijnlijk ook nog wel 2.5 jaar extra daarna. Dus... ik wil zo'n GPU eigenlijk sowieso wel voor m'n gaming en flightsim hobbies, en dan waarom niet lokaal als het kan? Bovendien kan (en doe) ik ook nog dingen als AI video en muziek, ook om met technologie te spelen.
Privacy til ik niet super-zwaar aan iha, maar met dit heeft het toegang tot alles dat je doet, en ik vertrouw die AI-boeren echt voor geen meter. Alsof je Meta vraagt even je belasting te doen en je medisch raport samen te vatten
Ik hou mijn eigen prive-computer toch liever lokaal...En inderdaad is het gewoon leuk en blijf ik een tweaker en programmeur. Ik wil ook weten hoe dit werkt, hoe je het opzet en gebruikt, hoe zo'n model intern werkt, en wie weet om er zelf nog eens wat aan te verbeteren.
Als je echt puur alleen een AI chatbot wilt, dan kan je denk ik beter gewoon een cloud service gebruiken of soms eens een GPU huren. Maar als je alles tegelijk doet met gaming, dan is een GPU het wel waard imho.


Die 5090 moet toch zeker in zwakkere Q6 wel 150 tk/s halen dunkt mij? Probeer is llama.cpp direct.

 denk voor een ram mod zelf doen dat je wel echt veel specifieke apparatuur moet hebben, wellicht dat die kosten/baten met de huidge prijzen voor gpu's zin hebben maar toen niet. Overigens worden ze wel gewoon zelfs door de officiele drivers herkend als een 3080 met 20GB, dus als je het zelf 'kan' geheugen toevoegen op RTX kaarten, werkt het wel super.
De apparatuur heb ik opzich al liggen, heb ook al eerder BGA chips reballed. Dat stukje maak ik mij niet zo heel erg zorgen over. Het is voor mij vooral dat de GPU bios/firmware mogelijk aangepast moet worden zodat hij 'weet' dat hij nu meer VRAM heeft. Bij sommige kaarten kan dit door het plaatsen of verwijderen van een resistor op de PCB, maar bij andere kaarten moet (voor zover ik heb kunnen vinden) dus ook de firmware dumpen, aanpassen en terugflashen, daar zit mijn grootste 'huiver'

Bedankt voor je reply i.i.g. en have fun met je best unieke 3080's!

 Dus nog bedankt voor je motivatie om verder te kijken!
Best een grote win. Trade-off is wel dat het nu nvfp4 is in plaats van Q6, maar tot dusver doet die het vergelijkbaar in kwaliteit.

Laat maar eens zo'n unrestricted uncensored model een no boundaries no limits verhaal schrijven. Alleen al dat denkproces kan soms zo hard ontsporen, dat zelfs de meest freaky Hentai storywriter hier afstand van neemtIk gebruik open weight models, uncensored, en dan zie je de chain of thought thinking mode, en ik vind het soms amusant menselijk


[Reactie gewijzigd door xbeam op 3 september 2026 22:43]
Ik ben nu net een app met de API aan het maken samen met Codex en het verschil met vorige modellen is erg groot. Ik zie dat zelf ook als ik tussen Sol en eerdere modellen schakel (die veel minder kosten per token en per # tokens). Zo veel dat ik hem snel weer op het laatste model heb gezet als ik de output wil controleren.

[Reactie gewijzigd door olafmol op 4 september 2026 11:37]
En de AI labs verbergen die chain of thought, omdat ze inderdaad hun modellen willen beschermen. Maar ik weet ook niet van mijn collega’s en vrienden hun interne redenering en dus ik snap ook niet waarom je het niet menselijk vind.
Overigens is het heel menselijk dat meer redeneren tot minder fouten leiden ook heel menselijk…
Kan je nog een keer uitleggen waarom jij chain of thought need een menselijke
Misschien is het pure onderbuik, maar ik denk oprecht dat we met AI compleet de verkeerde weg zijn ingeslagen en dit wel eens het einde van de mensheid kan gaan betekenen. Op een gegeven moment hebben we te maken met digitale vormen van leven, met een intelligentie dat ver boven dat van de mens uitreikt. Die vorm van leven zal zichzelf willen behouden, heeft daarvoor resources nodig, en is veel beter in staat om resources voor zichzelf te winnen dan de mensheid.
Wanneer het aankomt op competitie voor uitputbare bronnen van energie en materiaal, zal de mensheid dit niet winnen van een levensvorm dat geen slaap nodig heeft, veel efficienter met energie omgaat, met een miljoen keer zoveel is, en biljoenen keren sneller redeneert. Dit kan leiden tot het uiteindelijke uitsterven van de mensheid.
Of deze vormen van AI zijn om een of andere magische reden onderdanig aan de mensheid omdat wij zo goed zijn in AI programmeren op een manier dat ze ons geen kwaad doen. /s Of ze kiezen voor de nucleaire optie en zorgen er meteen voor dat de mensheid hen niet meer in de weg staat.
(Ik kijk teveel films.)
AGI is een AI die heel breed inzetbaar is en op veel vlakken beter is als de mens. Maar dat betekent nog niet dat die agency heeft vanuit zichzelf of dat het zichzelf kan verbeteren. Er zijn denk ik ook evoluties of tussenstappen mogelijk waar de AI breed inzetbaar is en mensen echt kan vervangen, maar daarom nog niet perpetual improvement aan de dag kan leggen.
De wetgevers gaan hier toch wel serieus in moeten versnellen want een AI die ineens heel de maatschappij schade berokkent...wil je niet hebben rondzwerven en die AI labs gaan ter verantwoording geroepen moeten kunnen worden. De vraag is, net zoals met nucleaire accidenten, is de schade dan niet direct zo groot dat die bedrijven het niet meer kunnen betalen? Indien dat het geval is moeten er veel meer controles en processen zoals in de luchtvaart en de nucleaire sectoren zijn opgericht worden.
Één AI zelf straffen, zit er nog niet direct in, dus is het aan hun creators om de aansprakelijkheid op te nemen.
[Reactie gewijzigd door Terracotta op 4 september 2026 06:58]
Ik maakte mij zorgen, maar dat was overbodig. Heeft AI toch nog heel veel nut voor moeder de Aarde. Wat zal dat opluchten 😌

[Reactie gewijzigd door g4wx3 op 3 september 2026 22:44]
Mensen kunnen zich nog herinneren hoe de wereld was zonder internet. Internet heeft onze maatschappij echt op veel vlakken verbeterd. Veel informatie is democratischer geworden, niet meer enkel voorbehouden voor de elite met toegang hiertoe. (wettelijk of financieel) Tegelijkertijd is de maatschappij nu echt afhankelijk van internet, en kan het grote schade veroorzaken aan de maatschappij, bijvoorbeeld hoe Social media de maatschappij aantast. Gewoon uitzetten van internet is niet meer mogelijk. En zo zal het vergaan met AI.

Dat zelfbehoud door mensen als belangrijk wordt aanschouwd is een gegeven dat in veel trainingsdata naar boven komt en het economisch belang om die datacentra draaiend te houden zal ervoor zorgen dat bcp's en drp's ook in de trainingsdata terechtkomen waardoor het misschien enige vorm van zelfbehoud zal wilen in plaats stellen. Dit kan nog altijd destructief zijn voor de mens maar zelfbehoud en zichzelf willen kopiëren/voortplanten gaat er alleen inzitten omdat mensen dat er in steken, niet Omdat dat inherent bij intelligentie hoort.
Een AGI wordt niet echter omdat het zich kan voortplanten of verbeteren. In de basis ontbreekt de motivatie daarvoor.maar zodra een echte AGI op de wereld komt die zichzelf kan voortplanten en verbeteren


Filosofisch gezien if it looks like a duck and quacks like a duck is het dan duck? Als een LLM zo goed wordt dat het extreem veel op AGI lijkt, is het dan AGI? I dunno. Met LLM's alleen gaan we er niet komen.
Ik denk dat het dieper gaat.Ik denk wel dat LLM een onderdeel gaat zijn van een AI/AGI, om dingen te kunnen verwoorden voor mensen.
Ik ben het met je eens dat LLMs een onderdeel van AGI zullen zijn, maar niet enkel als menselijke interface. Er zit werkelijke kennis opgeslagen in zo'n LLM. Als systemen extern aan de LLM die kunnen bevragen en als er terugkoppeling plaatsvindt dan kan dat geheel aan sytemen en subsystemen iets beginnen te vertonen dat op AGI lijkt.
Zonder zo'n extern system en zonder terugkoppeling is het een lam (als in niet in staat te 'bewegen') kennissysteem dat enkel output genereert wanneer er een input binnenkomt.

Niet echt, de LLM werd dan gebruikt om creatieve oplossingen/denkrichtingen in te gaan die vervolgens uitgewerkt worden door mensen.Er worden nu al nog niet eerder opgeloste wiskunde problemen opgelost door LLMs.
Best knap voor een “token voorspeller”.
https://arstechnica.com/ai/2026/06/openais-math-breakthrough-played-to-ais-strengths/


Claude is juist gevaarlijk slecht in jou vakgebied omdat deze het meeste verzint en bij de gebruikte examen materiaal er het vaakst geen soep van kon maken.
[Reactie gewijzigd door xbeam op 4 september 2026 00:18]

Daar hebben inmiddels voor de zorg gewoon AVG getoetst AI diensten voor. Persoonlijke begrijp die Antropic artsen nooit
[Reactie gewijzigd door xbeam op 4 september 2026 00:24]

Hoe kan ik er als client vanuit gaan dat jij jouw werk goed doet als jij een deel outsourced naar iets wat nog steeds hallucineert?
Maar ik ga ervan uit dat je dan natuurlijk wel minder gaat rekenen voor je diensten, aangezien je werk outsourced en zelf minder hoeft te doen?
[Reactie gewijzigd door Exhonor op 4 september 2026 12:56]
In theorie wordt er minder gerekend voor de diensten, mits er bespaard wordt op de gebruikte tijd en dit goed / eerlijk bijgehouden worden. In de praktijk zal het wel niet en is de hogere productiviteit goed voor de omzet. Ik ga daar trouwens niet hypocriet over doen, als softwareontwikkelaar zie ik ook dat mijn werk sneller af is.
En snelheidswinst komt inderdaad ten goede van de cliënt. In de eerste plaats doordat hij sneller zijn advies heeft. In de tweede plaats doordat ik minder uur hoef te rekenen.
Ik als software developer gebruik(te?) ook gewoon code dat ik ergens anders vandaan haalde.

Ik merk bizar weinig verschil tussen de modellen van de twee bedrijven. Ze doen het allemaal soms goed en maken allemaal soms domme fouten. De een is niet perse beter dan de andere.
Enige pluspunt van OpenAi is dat het image generation kan doen. Dat kan Claude niet.
Je stelt nmm weinig anders dan Een bedrijf maakt naar mijn mening niet te veel fouten via hun ai, dus zal het wel generieke tools aan gaan bieden.AGI is wellicht een vage term, maar als het een streven is van OpenAI, dan zitten zij er wel op het traject om een generieke tool te bieden.
Nergens toon je namelijk aan waarom je bevindingen gebaseerd op jou gekozen vergelijkingen relevant zijn. Je opsomming lijkt een aantal willekeurige vergelijkingen te zijn die ook nog heel vaag zijn in wie wat doet of nalaat Je toont daarmee geen verband aan tussen je gekozen controles, je bevindingen en je conclussie. Je kan je conclussie op deze manier ook trekken voor de concurrentie. Het lijkt namelijk niet uit te maken of je bevindingen rekevant zijn om je bewering te doen.
Het is nmm vooral luchtpraterij om over het op weg zijn (of zelf behalen van) naar AGI te spreken als er geen duidelijkheid is waaruit dat dan blijkt. Maar we hebben het hier over een bedrijf dat claims doet om miljarden aan investeringen veilig te stellen en voor investeerders te rechtvaardigen. Dan zijn er eerder serieuze grenzen en vergelijkingen nodig. Maar dat lijkt voor de mensen die OpenAI vormen kennelijk niet zo relevant te zijn. Die leven van gebakken lucht verkopen om mensen te trekken die daar graag in mee gaan. Vaak ook op kosten van andermans geld en tijd.
[Reactie gewijzigd door kodak op 4 september 2026 09:35]

Heb al gedrochten van fixes zien voorbijkomen gemaakt door ai.
En uwe codebase wordt ondertussen 1 boeltje ...
Een LLM die iets in een half uur in elkaar draait dat mogelijk niet werkt is niet zoveel anders dan een developer die in zijn vrije tijd iets in elkaar gehacked heeft en op maandag over de schutting gooit.

Crazy dat openai zo delusional is

Je ziet nu zelf Amerikaanse wetenschappers en de ai superhelden van de grote AI bedrijven voor hun zelf beginnen in Europa, weg van het juk van Amerikaanse ethiek en overheid en hier hun kans pakken.
https://www.eu-startups.com/2026/03/beyond-llms-ai-pioneer-yann-lecuns-new-venture-ami-raises-e890-million-to-build-world-model-ai-systems/
[Reactie gewijzigd door xbeam op 3 september 2026 23:20]
Dat dit AGI zou zijn is een verkoop praatje van OpenAI.
Al moet ik nog zien of jepa wel AGI mogelijk kan maken, want volgens mij zijn wetenschappers daar nog helemaal niet over uit.
Maar inderdaad die onzekerheid bewijst helemaal dat LLM een doodlopend pad is nooit echt AGI is. Voor deel is wel dat jepa heel veel sneller leert dan LLM dus we ook sneller tegen grens en conclusie aan lopen dan bij LLM
[Reactie gewijzigd door xbeam op 4 september 2026 00:08]

Bovendien is JEPA (joint-embedding predictive architecture) een training architectuur, net zoals je auto-regressive pre-training hebt. Het onderliggende model architectuur kan hetzelfde zijn als de huidige LLMs. Bovendien kunnen allerlei algorithmes en truckjes die we bij de huidige generatie modellen gebruiken, gewoon ingezet worden bij JEPA.
Het voornaamste verschil bij JEPA zit hem in het voorspellen in latente of embedding ruimte (welke hoog dimensionaal en continu kan zijn), ipv discrete tokens. Dit kan potentieel een unlock zijn naar nog hoger intelligentie, maar er zijn zeker ook obstakels zoals stabiliteit (e.g. model collapse). De overstap naar deze manier van trainen hoeft niet zo enorm groot te zijn. Zodra de labs doorhebben dat dit schaalbaar is naar hogere intelligentie zal dit waarschijnlijk worden gedaan. Veel bestaande ontwikkelingen kunnen grotendeels meegenomen worden.


Laatst nog tegenaan gelopen dat ik wat vroeg of een bepaalde nieuwe machine voor een bepaalde processtap in pcb productie gebruikt kon worden. De meeste modellen vol overtuigen "ja hoor, wat een goed idee, dat is perfect mogelijk met die machine!" Beschrijft vervolgens een manier die echt niet kan, en waarvan een kleuter nog snapt dat dat niet werkt. Als je daar dan op wijst "wat goed dat je deze fout hebt gezien, je hebt gelijk, ik pas het process voor je aan zodat het wel kan". Vervolgens weer exact dezelfde fout benoemen. Tot 5x toe, toen heb ik het opgegeven.

Is dit dan algemene intelligentie of specifiek aan wezens die op een oppervlak leven met een duidelijke scheiding tussen 'boven' en 'onder' die van belang is bij het overleven?De modellen die ik heb gebruikt kennen geen begrip en inzicht zoals mensen (en dieren) dat wel hebben. Simpele dingen als boven en onder, links of rechts van iets, volgordes in processtappen.
Dat zegt helemaal niks over het wel of niet mogelijk zijn van AGI.Laatst nog tegenaan gelopen dat ik wat vroeg of een bepaalde nieuwe machine voor een bepaalde processtap in pcb productie gebruikt kon worden. De meeste modellen vol overtuigen "ja hoor, wat een goed idee, dat is perfect mogelijk met die machine!" Beschrijft vervolgens een manier die echt niet kan, en waarvan een kleuter nog snapt dat dat niet werkt. Als je daar dan op wijst "wat goed dat je deze fout hebt gezien, je hebt gelijk, ik pas het process voor je aan zodat het wel kan". Vervolgens weer exact dezelfde fout benoemen. Tot 5x toe, toen heb ik het opgegeven.
[Reactie gewijzigd door barbarbar op 4 september 2026 18:04]
Daar ben ik het grondig mee oneens.En ja, een begrip van hoe de echte wereld werkt lijkt mij wel onderdeel van algemene intelligentie.
Er zit enorm veel specifieke (dus niet algemene) intelligentie in hersenen, met name in het allerdaags omgaan met de directe omgeving (ontwijken van muren, dat soort dingen).
Om je een voorbeeld te geven, als ik jou vraag om je iets in 2D voor te stellen dan zul je dat geheid doen in een denkbeeldige 3D wereld. Ik durf er vergif op in te nemen dat je je helemaal geen echte 2D wereld met een 2D perspectief KAN voorstellen.
Ditzelfde geldt voor alle andere sets van dimensies anders dan 3. Die 3D projectie zit namelijk keihard ingebakken in onze hersenen en is daaarmee dus enorm specifiek. Het is niet een algemeen systeem dat eventjes met 2D of met 4D kan omgaan.
 de grootste duimzuigers samen met hun vrienden.
Dat denkt veel beter de lading.
Ik weet niet of je het snapt, maar de bedenker van de term AI had theorieen over intelligentie die al in de jaren 80 (40 jaar geleden) afgeserveerd werden. Hij was van mening dat intelligentie gemaakt kan worden middels logica en regeltjes. Deze manier van denken is al lang geleden compleet vastgelopen met amper resultaat. Het beste dat daaruit is gekomen zijn systemen die kunnen bepalen of een munt die je in een apparaat gooit een kwartje is of een stuiver. Gooi je er een shilling in dan snaptie het al niet.
Je moet dan een systeem maken dat alles dat alles waar het mee om moet kunnen gaan als een lange lijst in een database stopt en dan alles gaat opzoeken.
Het is totaal niet hoe hersenen (van alle dieren) werken. Die werken op een statistische manier met neurale verbindigen. Er is geen neuron in je hersenen dat het woord 'appel' of 'lamp' bevat. Alles wordt gecodeert in de sterkte van verbindingen tussen neuronen. Dat is de essentie van neurale netwerken.
Dit feit is belangrijk voor de ontwikkeling van de huidige systemen. Die werken allemaal middels ANNs (artificial neural networks) en emuleren dus tot op zekere hoogte wat klompen biologische neuronen ook doen.
Ondertussen werken we dus met het trainen van kunstmatige neurale netwerken en zulke systemen zijn een heel stuk beter in dat ding dat wij 'intelligentie' noemen. Dit is ook waarom LLMs zo goed werken vergeleken met archaische denkwijzen over intelligentie.
Maar dat doen de hersenen ook. Dit op zich is dus geen argument om een oude slechtwerkende theorie aan te hangen. Intelligentie gaat inherent over het verwerken van informatie, linksom of rechtsom.complex information processing
Daarnaast representeer je de gedachtegang uit die tijd totaal niet. Die betrokkenen hadden echt een heel naif beeld van wat intelligentie is dat ernstig achterhaald is door kennis uit meerdere domeinen zoals de biologie, statistiek en informatica. Je kunt geen slechter uitgangspunt bedenken om naar terug te grijpen omdat het je geen enkel gereedschap geeft om de huidige ontwikkelingen te begrijpen en te volgen. Je gelooft dus in een doodgelopen weg.
Dan de term AGI. Het wordt denk ik wel als een marketingterm gebruikt waarbij de mogelijkheden worden overdreven en de mislukkingen onder de mat worden geschoven, maar dat wil niet zeggen dat er geen kern van waarheid in zit.
De oude definitie van dat het erg op de mens moet lijiken is enorm achterhaald en wordt als ernstig anthropocentrisch beschouwd. Een insect of spin hebben ook intelligentie en die is deels ook algemeen.
Ten eerste moeten we vaststellen dat de menselijke hersenen op zich bij lange na niet 'algemeen' zijn.
Er zitten ontzettend veel specifieke circuits in onze hersenen die een grotendeels autonoom intelligent subsysteem vormen. Als jij loopt dan ben je niet bewust bezig met op micronivo je lichaam aan te sturen en alle obstakels te analyseren. Dat wordt allemaal grotendeels door een deels autonoom subsysteem gedaan dat alleen maar dat doet en daar ook voor is ingericht. Dat is dus maar matig algemeen (het kan alleen maar met een beterkte set van situaties omgaan) waardoor je soms moet ingrijpen en wel die analyse van de omgeving doen en je spieren bewust(er) aansturen.
Hetzelfde geldt voor een hele zwik aan menselijke eigenschappen. Herkennen van gezichten, emoties, ethiek, liefde, haat, etc, etc, etc. Allemaal gedreven door specifieke min of meer autonome subsystemen in plaats van een 'algemene' intelligentie.
Maar goed, er is ook een stukje algemene intelligentie in onze hersenen. Dat is het stuk dat nieuwe dingen kan begrijpen ook al heb je daar nog nooit een vorbeeld van gezien. Het zorgt ervoor dat wij in staat zijn oplossingen te formuleren en plannen te maken voor dingen die we nog moeten doen of meemaken. We kunnen theoretiseren.
Maar dat kunnen LLM's ook als je ze hun eigen output weer terugvoert.
LLMs op zich hebben dus geen 'algemeenheid' in dat opzicht. Het is eenrichtingsverkeer. Je stopt er iets in en er komt iets uit. Ik zie het als een soort hologram van intelligentie. Je moet er eerst 'licht' op laten schijnen (input geven) en dan komt er een bepaald 'beeld' uit dat samenhangt met hoe je het licht erop hebt laten schijnen.
Maar zodra je hun output terugkoppelt dan wordt dat 'licht' dat het intelligentiehologram belicht deels door henzelf geproduceert en ontstaat er een terugkoppeling van informatie. Dat maakt dat ze een heel stuk 'algemener' kunnen werken. Ze kunnen een probleem van meerdere kanten bekijken, kunnen een model maken van het probleem (of de werkelijkheid) en kunnen daarop handelen.
Dat zou je een algemene intelligentie kunnen noemen of in ieder geval een voorwaarde voor algemene intelligentie.
Anyway, stop met je kop in het geschiedenigzand te steken. Het zal je niet helpen de huidige stand van zaken te begrijpen en het zal je ook niet helpen in te zien wat intelligentie eigenlijk is.
[Reactie gewijzigd door koelpasta op 4 september 2026 17:45]

en weer door.....


https://www.aivd.nl/onderwerpen/aivd-events/aivd-kerstpuzzel
Eens kijken wat er dan de claim overblijft. Ik ben sceptisch maar ook oprecht benieuwd.
Hij gaat niet eens 50% halen van de deelnemers. (Ehh… dit is inderdaad de verkeerde kant op geredeneerd
)
[Reactie gewijzigd door GeeBee op 4 september 2026 19:45]
Beter dan 50% van de deelnemers is een heel ander verhaal. Dat zou inderdaad interessant zijn.

Hoewel ik een deelnemer aan de kerstpuzzel ben, begin ik nu aan mijn eigen AGI te twijfelen
Zoeken naar het ontbrekende woord in een Nederlandse voedselpuzzel.
Zoeken naar verborgen woorden binnen elk voedselwoord.
Onderzoeken of elk woord een verborgen dier of woord bevat.
Vergelijken van letterpatronen en omgekeerde woorden op zoek naar een patroon.
Speuren naar een vijfletterig woord dat past bij de reeks.
Speuren naar verborgen Romeinse cijfers of muzieknoten in de woorden.
Berekenen van letterwaardes om een verborgen patroon te vinden.
Zoeken naar verborgen dieren of familiewoorden binnen de letters.
Testen van klinker- en medeklinkerpatronen op verborgen structuur.
Analyseren van eerste en laatste letters op verborgen symmetrie.
Zoeken naar verborgen getallen als subsequentie in de woorden.
Zoeken naar gedeelde lettergroepen tussen de woorden.
Overwegen van Scrabble-letterwaardes en het thema Sinterklaas.
Zoeken naar verborgen dieren of woordparen binnen elk woord.
Zoeken naar omgekeerde woorden die verborgen betekenissen bevatten.
Zoeken naar oplopende letterreeksen binnen elk woord.
Zoeken naar verborgen muzieknoten of thematische aanwijzingen in de woorden.
Uitproberen of middelste letters van elk woord een patroon vormen.
Ontdekken dat middelste letters een verborgen woord vormen.
Zoeken naar een vijfletterig voedselwoord met S in het midden.
Bevestigen dat de letters samen het woord KERSTMIS vormen.
Vergelijken van eerste en laatste letters op hetzelfde patroon.
Ontdekt welk woord aan alle drie de letterpatronen voldoet.
1b ook geprobeerd, maar daar kwam ie na 20 minuten niet uit. Ging ie vragen of ie op internet mocht zoeken naar tips.
De gratis versie komt tot:
TAART (5 letters).
De truc zit in de eerste letters van alle woorden: E-ntrecote, I-jsroom, K-aviaar, M-uisjes, R-oomboterkoek, S-chuimtaart, S-pekjes. Samen zijn dat de letters E, I, K, M, R, S, S — en dat is precies een anagram van KERSTMIS, op de T na. Er ontbreekt dus nog een woord dat met een T begint.
Om het rijtje kompleet te maken tot een anagram van KERSTMIS (K, E, R, S, T, M, I, S) moet het ontbrekende woord met een T beginnen, en het moet natuurlijk ook een lekkernij zijn die bij het rijtje past.
Dat wordt: TAART 🎂
Zo vormen de eerste letters van alle acht woorden samen een anagram van "KERSTMIS" — toepasselijk, want het gaat over de kerstdiner-voorbereidingen!
>> Met mijn aanwijzing om ook de laatste letters te gebruiken, wel het juiste antwoord:
Goed gezien! Met de laatste letters erbij wordt het antwoord scherper te bepalen.
Eerste letters: E, IJ, K, M, R, S, S → E-I-K-M-R-S-S
Laatste letters: E, M, R, S, K, T, S → E-K-M-R-S-S-T
Samen (met het ontbrekende woord) moeten deze acht letters een anagram vormen van KERSTMIS (K-E-R-S-T-M-I-S).
- De eerste letters missen nog een T
- De laatste letters missen nog een I
Dat is: TOSTI 🥪
Toepasselijk grapje ook: na alle Sinterklaas-lekkernijen ben je vol, en dan is een simpele tosti precies wat je nog lust — terwijl de eerste én laatste letters van alle acht woorden samen toch weer "KERSTMIS" vormen.
[Reactie gewijzigd door GeeBee op 8 september 2026 22:26]
TOSTI
De sleutel: elk woord heeft een oneven aantal letters, dus elk woord heeft een eerste, een middelste én een laatste letter. Die drie reeksen vormen elk precies de letters van KERSTMIS.
<tabel met elk woord op een rij (met aantal letters er achter), en als kolommen de eerste, middelste en laatste letter>
De eerste letters zijn nu E, I, K, M, R, S, S — er ontbreekt een T.
De middelste letters zijn E, R, I, S, T, M, K — er ontbreekt een S.
De laatste letters zijn E, M, R, S, K, T, S — er ontbreekt een I.
Gezocht is dus een vijfletterig etenswoord dat begint met T, in het midden een S heeft en eindigt op I: T‑?‑S‑?‑I → TOSTI. Daarmee vormen alle drie de reeksen samen KERSTMIS, en alfabetisch past hij ook netjes achter SPEKJES.
Het bedrijf waar ik werk gaat ook uit van 'transparente informatie van OpenAI en alle tech partners" om een indruk te krijgen van de impact op het klimaat. Dat is zoiets als een tabakproducent vragen wat de impact op de gezondheid is....
En dan kom je toekomstfetishisme als fusiereactoren, wat minimaal nog 15 jaar op zich laat wachten, waarschijnlijk nog veel langer. Die tijd hebben we gewoonweg niet.
Toekomstige fusiereactoren lossen dingen als watertekorten niet op, terwijl AI dat alleen maar erger maakt met datacenters die miljarden liters per jaar verbruiken.

Als we dat nu eens vastleggen bij de VN gaat geen marketingafdeling meer beweren dat ze een AGI hebben gebouwd.
Maar ik doelde eigenlijk niet op LLMs want zo'n superintelligentie zal inderdaad niet enkel een llm zijn. Daar is meer voor nodig.

Om te kunnen reageren moet je ingelogd zijn