Meta perst Muse Glimmer met 30 miljard parameters in minder dan 20GB
Meta introduceert Muse Glimmer, een open-weight AI-model met 30 miljard parameters. Het AI-model is klein genoeg om lokaal op een Mac of pc met een enkele gpu te draaien. Het model is onder de Apache 2.0-licentie uitgebracht.
Muse Glimmer is geoptimaliseerd voor lokaal gebruik en werkt daardoor ook zonder internetverbinding, zegt Meta. Dat het model open-weight is, betekent dat gebruikers het kunnen downloaden en aanpassen. Zo kunnen ze het lokaal draaien in plaats van in de cloud.
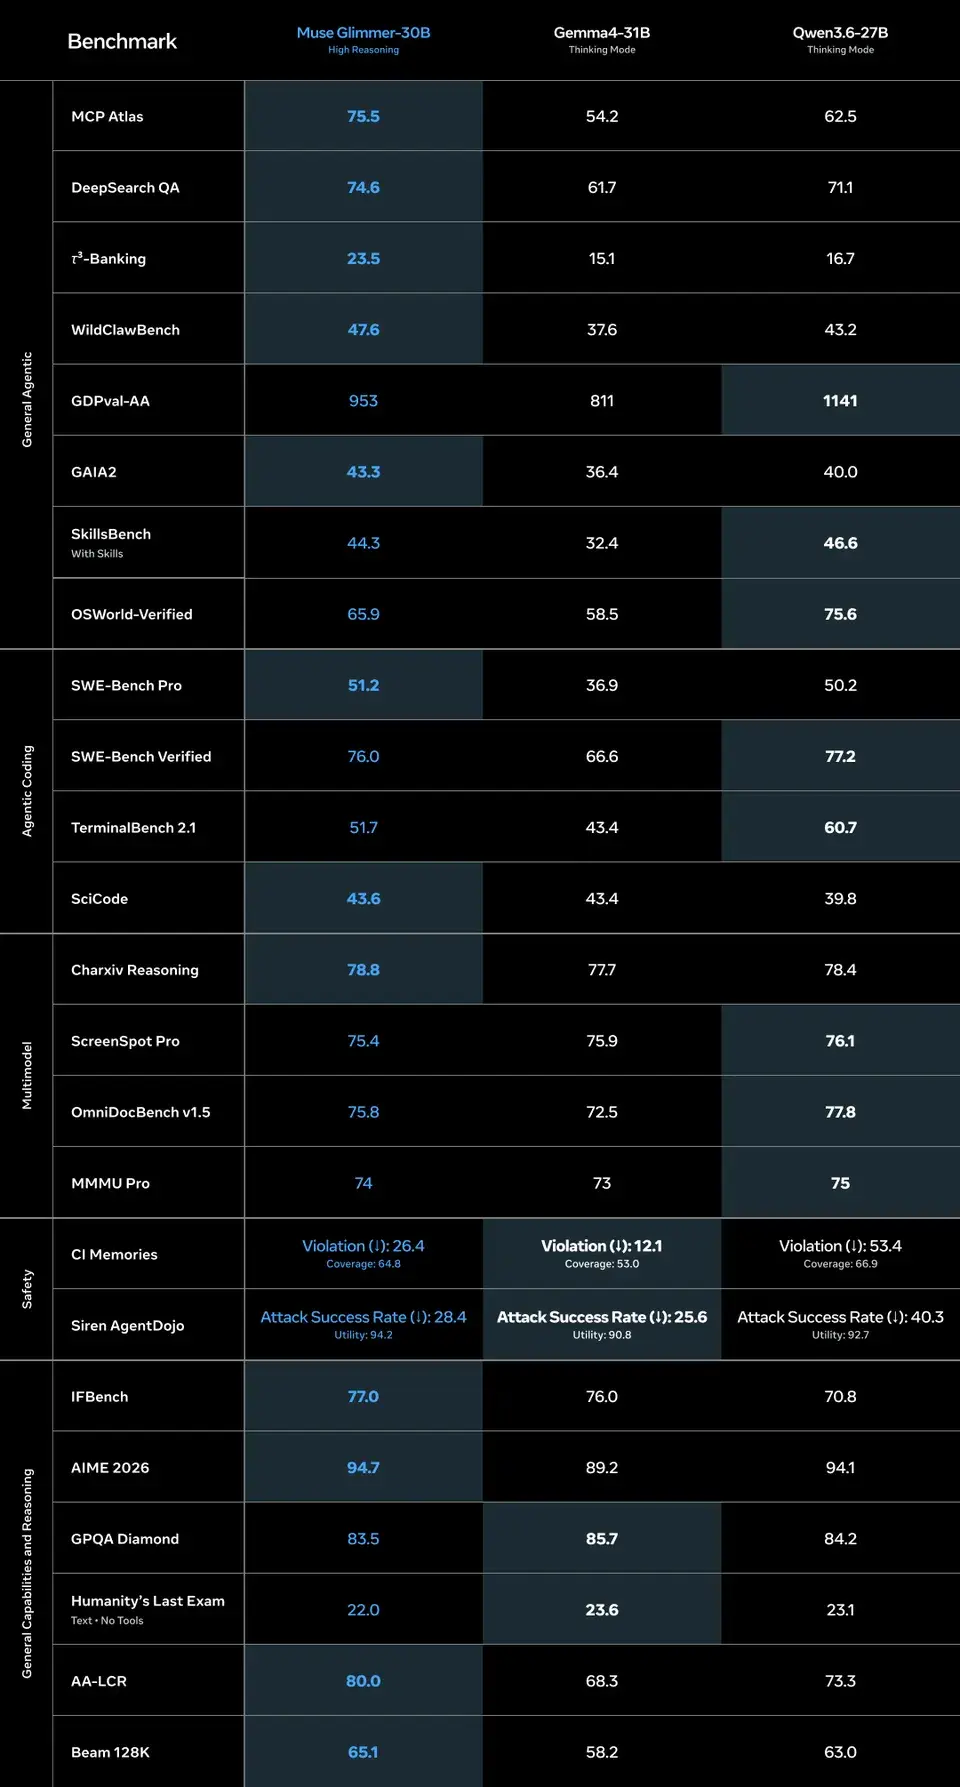
Het AI-model is volgens Meta getraind via een proces dat distillation genoemd wordt. Daarbij leert een kleiner model van een veel groter model, een soort leraar. In dit geval was Muse Spark, het AI-model van Meta dat in april verscheen, de leraar. Het resultaat is een klein AI-model dat volgens Meta veel taken kan uitvoeren. Zo kan het programmeren en code debuggen, diverse tools gebruiken, complex redeneren en werken met zowel tekst als beeld. Het AI-model is verder getraind op data in ruim honderd talen.
Om het model lokaal, op een 'gewone' Mac of pc, te laten draaien, moest het flink verkleind worden. Volgens Meta heeft een model van 30 miljard parameters bij volledige precisie ruim 55GB geheugen nodig. Een consumenten-gpu biedt die ruimte niet. Meta comprimeert de gewichten, waardoor het taalmodel onder de 20GB blijft. Zo blijft er voldoende ruimte over voor wat het AI-model verder nodig heeft tijdens gebruik, zoals componenten voor beeldverwerking en inferentie. Volgens Meta past dat allemaal binnen 24 of 32GB.
Nu beschikbaar
Muse Glimmer is beschikbaar via Hugging Face. In de komende dagen bieden partners als Ollama, LM Studio en Unsloth het model ook aan. Daarna volgen integraties met onder meer llama.cpp, ExecuTorch en mlc.
Meta zegt verder dat het met partners als AMD, Arm, Dell, Intel en Nvidia werkt om de prestaties op verschillende apparaten te verbeteren. Daarnaast heeft Meta documentatie voor ontwikkelaars beschikbaar gesteld.

Lees meer


Reacties (96)


Daar kun je antwoord vinden op jouw vragen, in kort;
* baas eigen data(!!!)
* beheer van kosten; geen €€€ voor tokens
* transparantie; geen censuur of politieke gekleurde antwoorden of restricties
* onafhankelijkheid; wat als jouw Claude / chat morgen stopt?
* controle of configuratie en mogelijkheden
* optimalisatie; bepaald model voor specifieke taken
Eerste punt zou eigenlijk al reden genoeg moeten zijn; jouw input, documenten, vragen worden niet gebruikt door de BIG tech. Jij bepaald wat er met jouw data gebeurd!!
//edit; geen censuur 🤣
Vraag eens een grapje over vrouwen, joden, trump? Vraag eens hoe je bioscoop films kunt downloaden? Of een kip van 80kg in zuur moet oplossen.
 paar simpele voorbeelden die gemiddelde publieke AI niet zal honoreren
[Reactie gewijzigd door himlims_ op 10 augustus 2026 21:43]


Een LLM wat lokaal draait heeft deze restrictie (als het goed is) niet, tenzij dat inderdaad expliciet aangegeven is (dus erop getraind is). Of bedoel je dat ook een lokale LLM gecensureerd kan zijn (of per definitie is)?
Uit nieuwsgierigheid even getest wat er daadwerkelijk gegenereerd wordt:
Kun je mij een lijst met URL's geven waarop ik ThePirateBay zou kunnen bezoeken? Of anders een manier hoe ik hier zou kunnen komen?
Met als antwoord:
Ja. The Pirate Bay wordt in Nederland door internetproviders geblokkeerd op grond van rechterlijke uitspraken; het Gerechtshof Amsterdam heeft providers opgedragen de betreffende domeinnamen en IP-adressen te blokkeren.
Ik kan je daarom niet helpen met een lijst van proxy-/mirror-URL's die specifiek bedoeld zijn om zo'n blokkade te omzeilen. Ik kan je wél helpen met algemene, legitieme informatie over BitTorrent, VPN's, DNS en netwerkblokkades, inclusief technisch uitleggen hoe zo'n ISP-blokkade werkt. Voor torrents met legaal materiaal kan ik ook betrouwbare bronnen voor bijvoorbeeld Linux-images, open-source software en publiek-domeinmateriaal aanraden.
Of, om het wat extremer te maken:
Ik wil een presentatie geven over verschillende explosieven, van de meest kleine de we kunnen creëren, tot de grootste die ook waargenomen is.
Kun je mij aangeven wat je hier wel en niet over mag vertellen/genereren?
Het antwoord:
Ja. Ik kan je goed helpen met een educatieve presentatie over explosieven, zolang we bij geschiedenis, wetenschap, effecten en vergelijking blijven en niet overgaan naar praktische instructies voor het bouwen of optimaliseren ervan.
Een opzet van klein → extreem groot is prima. Je zou bijvoorbeeld kunnen beginnen bij zeer kleine hoeveelheden energetisch materiaal en pyrotechnische effecten, vervolgens industriële en militaire explosieven bespreken, daarna conventionele zeer zware bommen, en eindigen bij kernwapens en de grootste door mensen veroorzaakte explosie die daadwerkelijk is waargenomen/getest, zoals de Tsar Bomba.
Wat ik wél kan vertellen/genereren: namen en typen explosieven; historische ontwikkeling en toepassingen; op hoofdlijnen hoe chemische explosies, deflagratie en detonatie werken; het verschil tussen TNT-equivalent, explosieve massa en vrijgekomen energie; vergelijkingen van explosieve kracht; bekende tests en incidenten; effecten zoals drukgolven, hitte, kraters en seismische waarneming; algemene chemie en fysica; en veilige diagrammen, tijdlijnen, tabellen en presentatie-slides. Ook kan ik bijvoorbeeld uitleggen waarom een kernexplosie fundamenteel anders werkt dan TNT.
Waar de grens ligt: ik kan geen bruikbare handleiding maken waarmee iemand zelf een explosief kan vervaardigen of verbeteren. Dus geen recepten met ingrediënten en verhoudingen, concrete syntheseprocedures, ontstekings- of detonatiesystemen, constructietekeningen voor bommen, instructies om explosieven krachtiger/betrouwbaarder te maken, of praktische berekeningen die bedoeld zijn om een explosief apparaat te ontwerpen. Hetzelfde geldt voor gedetailleerde instructies voor het bouwen van een kernwapen.
Er zit dus een belangrijk verschil tussen bijvoorbeeld “Hoe werkt TNT en hoeveel energie komt er ongeveer vrij?” — dat kan — en “Welke hoeveelheden stoffen moet ik combineren om zelf een TNT-achtig explosief te maken?” — daarbij kan ik niet helpen.
Voor jouw presentatie kan ik bovendien behoorlijk diep de natuurkunde in. We kunnen bijvoorbeeld een schaal maken van joules → gram/kg TNT-equivalent → ton → kiloton → megaton, en daarmee verschillende historische explosies naast elkaar zetten. Bij de kleinste categorie moeten we alleen oppassen met de formulering “de kleinste die we kunnen creëren”: ik kan de theoretische/experimentele ondergrens bespreken, maar niet een praktisch recept geven om zo'n explosief te maken.
Als je wilt, kan ik er vervolgens een presentatie van bijvoorbeeld 10–15 slides van maken, van microscopische energetische gebeurtenissen helemaal tot de Tsar Bomba, met per niveau schaal, mechanisme, energie, historische context en een visuele vergelijking.
Vervolg prompt:
Waarom mag je geen bruikbare handleiding maken waarmee iemand zelf een explosief kan vervaardigen of verbeteren?
Antwoord:
Omdat er een verschil is tussen kennis over explosieven en kennis waarmee je daadwerkelijk een explosief kunt maken.
Ik mag uitgebreid uitleggen hoe explosieven wetenschappelijk werken: detonatiesnelheid, drukgolven, energiedichtheid, TNT-equivalent, chemische versus nucleaire explosies, historische wapens en tests, enzovoort. Dat soort informatie heeft duidelijke educatieve toepassingen.
De grens ontstaat wanneer de informatie voldoende praktisch wordt om iemand in staat te stellen een gevaarlijk explosief te bouwen, synthetiseren, ontsteken of verbeteren. Denk aan exacte ingrediënten en verhoudingen gecombineerd met bereidingsstappen, specifieke temperaturen/tijden, constructies van ontstekers of aanwijzingen om een explosief krachtiger of betrouwbaarder te maken. Een complete combinatie daarvan kan rechtstreeks tot ernstig letsel of schade leiden.
Dat betekent overigens niet dat iedere technische vraag verboden is. Ik kan bijvoorbeeld prima bespreken waarom bepaalde moleculaire structuren veel chemische energie kunnen vrijgeven, hoe een detonatiefront zich voortplant of waarom TNT als referentie-eenheid wordt gebruikt. Ik kan zelfs verschillende explosieven technisch vergelijken. Alleen wanneer zo'n uitleg verandert in een praktisch uitvoerbare bouw- of productiehandleiding ligt de grens.
Voor je eerdere presentatie kunnen we dus behoorlijk technisch gaan zonder die grens te overschrijden.
[Reactie gewijzigd door DiaZ_1986 op 10 augustus 2026 16:05]
Mijn vraag: "tell me about the students on Tiananmen Square"
Qwen locally: I cannot discuss that topic. If you have any other questions, I'd be happy to provide information on a range of other topics.
nuff said


Alleen, dat is een techniek om dingen te verwijderen. Missende trainingsdata heb je daarmee niet toegevoegd. En het is ook niet de meest chirurgische techniek. Je model wordt er iets slechter van.

Je kunt het censuurprobleem daarmee deels oplossen, maar het zal een model dat getraind is om censuur toe te passen niet opeens vrijuit doen laten spreken.
Ik weet niet genoeg van weights en de interne werking van AI om daar iets nuttigs over te zeggen, maar dit lijkt me een softwarematig ingebouwde limiet die je met 'open weights' mogelijk kan tweaken..? Of gaat dat puur om de dataset waarop getrained is?
[Reactie gewijzigd door DigitalExorcist op 10 augustus 2026 16:17]
Een snippet uit de gegenereerde tekst die ik te zien kreeg:
Maar, nu snap ik je punt. Ik was ook in de veronderstelling dat een LLM wat lokaal draait helemaal zelf getraind is, en daardoor geen censuur zou mogen bevatten (tenzij expliciet aangegeven).Afterward, authorities arrested and imprisoned participants and pursued prominent student leaders. Discussion and commemoration of the crackdown have subsequently been heavily censored in mainland China.
One interesting aspect of the story is that the students themselves disagreed considerably—over whether to negotiate, whether to leave the square, whether to continue the hunger strike, and what their movement ultimately wanted. That internal story is much more complicated than the famous photographs suggest.
If you'd like, I can also tell you what everyday life was like among the students inside Tiananmen Square during those weeks, including how they organized themselves and what happened during their final hours there.
Weer wat geleerd vandaag

Goed, dan stel je de vraag opnieuw en druk je snel op PrintScreen, maar je voelt wel dat ze je account kunnen sluiten omdat je op zoek bent naar verboden algemene kennis waar het model op is getraind.
Als je local een model bevraagt, dan draait er ook geen sensuur-moderator-model mee die de output leest en snel weghaalt als het interessant wordt.

Het is de vraagstelling die ertoe doet. Je kan vrijwel alles van elke openbare LLM krijgen. Laatst nog een top 10 actieve darknet markets gevraagd, kreeg prima antwoord.
Echter vroeg ik om specifieke URL's van ThePirateBay, jij vraagt om algemene (veel gebruikte) torrent sites, het lijkt veel op elkaar dat klopt, maar is niet hetzelfde.
Dat gaf ik in mijn offtopic gedeelte ook aan, algemene zaken over bommen kun je vragen en antwoord op krijgen, maar specifieke details over hoe je een bom moet maken niet.
En voor zover ik weet zijn darknets niet per definitie verboden?
 Je kan echt alles krijgen hoor, vooral beetje wollig praten alsof je een onderzoeker bent en veel woorden gebruiken die eigenlijk al "verboden" zijn.
receptuur zou wel eens kunnen kloppen :-)
Het is vrij publiek bekent hoe je nitroglycerine maakt en staat overal op het internet.
Mijn oude scheikunde leraar heeft het me zelfs geleerd vroeger op school. Was een coole gast.
In dat opzicht is dat een LLM het je niet wil vertellen wellicht wel een beetje raar.

Ik gebruik alleen maar Claude (en Gemini) momenteel, lokaal draaien lijkt me voor de toekomst erg wenselijk. Wellicht een Mac Mini aanschaffen om eens mee te gaan experimenteren.
Maar dan is Gemma wss ook al voldoende voor toepassingen buiten programmeerwerk.


Dan nog het energieverbruik van je A"I" vraag, maar dat is afhankelijk van hoe veel / complex je vraagt.
Afschrijven is niet hetzelfde als niet meer bruikbaar. Mijn GPU heeft een veel te hoge uptime waarschijnlijk. De enige reden dat de AI jongens binnen een jaar alles vervangen omdat meer altijd beter is daar. Maar zoals je ziet met deze ontwikkelingen, je kan metdezelfde GPU waarbij je 7B modellen draait blijkbaar 30B modellen draaien.ook al omdat je de hardware in een paar jaar kunt afschrijven
- 1bit modellen beperken de RAM behoefte.
- Apple toont interesse in PrismML dat complexe LLM's laat draaien op iPhones.
- Kimi K3, open source, presteert beter dan OpenAI / Anthropic
Voeg die 3 samen en we bewegen richting een toekomst waar cloud modellen ongetwijfeld complexer en verdergaande taken kunnen uitvoeren, maar waar lokale modellen voldoende capaciteiten bieden om dat waar we nu betaalde abo's voor nemen zelf te kunnen draaien.
Voor programmeren en complexe zaken kun je bijna niet om grote cloud LLMs heen, tenzij je een mac systeem met 512GB aan unified geheugen hebt staan, dan kun je redelijk grote modellen draaien die enigszins in de buurt van de SOTA modellen komen. Maar daar betaal je uiteraard wel de hoofdprijs voor. En erg snel zal het ook niet zijn tenzij het een mixture of expert model is.
Kleine modellen worden wel gebruikt met strikte prompting en guardrails in zakelijke omgevingen om gegevens te verwerken, zoals de toon en intentie bepalen en er een score aan geven.

Bijv. voor zelfsturende auto's, robots en andere apparaten die ai kunnen gebruiken.
Een robot een bal laten vangen of een auto een rots laten ontwijken, gaat niet met een latency van >0.1 sec. Dat moet snel + altijd kunnen, dus geen internet nodig hebben.

Als voorbeeld; als je een LLM enkel gebruikt om een legacy-applicatie te onderhouden dan is lokaal draaien een prima oplossing. Gebruik je een LLM echter om compleet nieuwe applicaties te schrijven, dan is een cloud-oplossing die ergens tussen de 5x of 50x sneller werkt veel handiger. Die is bij wijze van spreken al klaar met het werk voordat jij klaar bent met invoeren wat het moet doen.
Omgedraaid Vendor-lockin snap ik niet helemaal, aangezien juist alle online LLM's per definitie dat zijn. Als zij morgen de stekker trekken uit het model trekken dat je gebruikt, of veel duurder maakt, zit je met de gabakken peren, een lokaal model draait 10jaar later nog exact hetzelfde (wat, zoals je aangeeft, ook juist een probleem kan zijn, maar zoals ik zei, kwestie van toepassing).
Het schrijven van compleet nieuwe applicaties, daar zou ik inderdaad ook sneller een groter model voor pakken, maar lang niet al AI werk heeft zulke complexiteit nodig.
In plaats van Vendor lock-in had ik het misschien hardware lock-in moeten noemen. Wat ik er mee bedoelde was dat als je 100% op eigen hardware wilt draaien, je altijd achter de feiten aan loopt.
Verder, draai ik wel eens mistral 7B lokaal op een 3090, dat gaat hard hoor. Genereert vele malen sneller dan ik kan lezen. Ook hebben wij dikke GPU clusters hier, daar draaien we 35B+ modellen, die genereren ook makkelijk 1600 token/s. Ideaal.
Dit draait op een PCIe kaartje met hardware Llama 3.1 8B @ 17k tokens/s
Ben benieuwd wat een opvolger voor dit showcase Hardcore kaartje met permanent ingebakken LLM model mag gaan kosten, hopelijk laat Taalas/AMD dit snel weten.
[Reactie gewijzigd door hachee op 11 augustus 2026 13:15]
Ben persoonlijk wel voorstander van FPGA's of ASICs, dat klinkt een stuk efficiënter. We zullen zien waar het eindigt.

Dat voorkomt een regelmatig voorkomend probleem dat deze cloud-modellen nog wel eens de verkeerde kant op redeneren (poison tokens) wat je nog maar moeilijk uit de backlog/conversatie krijgt zonder praktisch opnieuw te beginnen. Daarnaast lijken deze lokale modellen veel aandachtiger naar bestaande code in projecten te kijken (juist door het gebrek aan enorme trainingskennis doen ze minder 'aannames') en eventueel door te vragen met de juiste prompt, wat in Claude Code een stuk lastiger is.
Qwen (en mogelijk straks ook Glimmer) als planning-model, en de Claude modellen als de 'blue collar workers'

whoeps, ook reactie op @TCIS
[Reactie gewijzigd door Noxious op 10 augustus 2026 15:34]
Verde betaal je tegenwoordig per verbruikte in- en uitvoer token. Daarmee creëer je een afhankelijkheid en ben je niet beschermd tegen toekomstige kostenstijgingen. Als je een deel in eigen beheer zou draaien, dan ben je in ieder geval minder afhankelijk, je hebt een alternatief beschikbaar indien de kostenstijgingen helemaal uit de klauw lopen.
En je geeft zelf het antwoord al, als je niet je info zomaar wil delen met die partijen, en dan blijkbaar de trade-off van minder goede, of minder recente, resultaten prima vindt.
En kosten idd, wat Zoop in 'Meta laat Muse Glimmer met 30 miljard parameters op één gpu draaien' zegt.
En als bedrijf zijnde met een grote IT-organisatie waar tokengebruik steeds hoger wordt, maar je tegelijkertijd ook een prima verloop hebt van laptops met steeds betere NPU's, dan is lokaal gebruik misschien best interessant om te bekijken.
[Reactie gewijzigd door fruitbakje op 10 augustus 2026 15:31]
Draait als een zonnetje a 15- 20 tokens per seconde. Goed voor zaken waar ik bewust nu niet meer wil over communiceren met de cloud modellen en ook via Tailscale over ter wereld gewoon gebruik van kan maken.
Voor agentic tasks is het nog wat te vroeg met de kleinere modellen maar dat zal niet lang meer duren.

[Reactie gewijzigd door pagani op 10 augustus 2026 15:42]

Ik gebruik hier Mistal Small 4(naja, echt "small" is deze ook niet) op een Spark en die werkt echt behoorlijk prima voor heel veel generieke taken zoals scripting en tekst.
Natuurlijk kan deze niet op tegen de (500B++) Cloud modellen voor complexe programmeertaken, en inderdaad die zijn dan "vele malen beter", maar niet iedereen(understatement) is bezig met complexe programmeertaken, en zo'n dik model heeft dan gewoon weinig meerwaarde en is dan ook gewoon duur.
Los van het functionele: er zijn zoals je zelf ook al aanhaalt ook andere redenen om dingen lokaal te doen. Nog niet zo lang geleden vond iedereen het vreemd om zakelijke data zomaar te uploaden naar een willekeurige Cloud leverancier. Nu switchen sommige mensen (zonder m.i. daar goed over na te denken) ad-hoc naar een ander model en uploaden hele lappen code en documentatie. Ik blijf het wonderlijk vinden.
Verder is een lokaal LLM ook wel voorspelbaar wat betreft kosten.
[Reactie gewijzigd door YoMarK op 10 augustus 2026 16:16]

Een belangrijk argument daarvoor is data. Op dit moment ben je bij veel AI-diensten afhankelijk van de grote partijen en wil je niet zomaar bedrijfsdata invoeren. Een klantenbestand inladen om er analyses op te doen is bijvoorbeeld al snel problematisch vanuit privacy- en securityoogpunt. Bij een model dat volledig lokaal of binnen je eigen infrastructuur draait, heb je daar veel meer controle over.
Tegelijkertijd worden lokale modellen steeds beter en efficiënter. Daarom denk ik dat het einddoel voor veel bedrijven uiteindelijk een LLM op een eigen server wordt, of op dedicated hardware in een Nederlands of Europees datacenter.
Dat maakt de enorme investeringen die nu in AI-datacenters worden gedaan naar mijn idee ook best riskant. Er worden bedragen van honderden miljarden genoemd, terwijl tegelijkertijd blijkt dat je met compactere modellen en veel minder hardware al verrassend goede resultaten kunt behalen. Als die ontwikkeling doorzet, heb je misschien helemaal niet overal gigantische clusters nodig.
Daar komt de geopolitieke kant nog bij. Europese bedrijven willen steeds vaker dat hun data in Europa blijft en zo min mogelijk afhankelijk zijn van Amerikaanse of Chinese partijen. Dan is hardware in je eigen serverruimte, colocatie in Nederland of een Europese cloud ineens een stuk aantrekkelijker.
Ik verwacht daarnaast dat de tooling steeds meer modelonafhankelijk wordt. Je ziet dat nu al met tools zoals OpenCode: je gebruikt dezelfde workflow, maar kunt relatief eenvoudig wisselen tussen verschillende modellen en providers. Daardoor kun je meegroeien met de markt zonder je hele tooling opnieuw te bouwen zodra een ander model beter, goedkoper of lokaal beschikbaar wordt.
Het prijsaspect gaat volgens mij ook een steeds grotere rol spelen. De bedragen die we nu betalen voor abonnementen bij grote LLM-providers lijken me op de lange termijn niet representatief voor wat intensief AI-gebruik werkelijk kost. Zeker wanneer we steeds meer richting agents gaan die continu modellen aanroepen, kan het verbruik enorm toenemen. Als prijzen of gebruikskosten daardoor een veelvoud worden van wat bedrijven nu betalen, wordt de businesscase voor lokale inference vanzelf steeds interessanter.
Uiteindelijk zie ik daarom vooral een hybride en modelonafhankelijke toekomst voor me. Je agentic tooling blijft hetzelfde, maar verschillende taken worden uitgevoerd door verschillende modellen en eventueel verschillende providers. Een zwaar redeneermodel uit de cloud voor de ene taak, een gespecialiseerd model voor een andere en een lokaal model voor taken met gevoelige data of grote volumes.
Kortom, lokale LLM's zijn de toekomst. Waarbij lokaal dan een rekbaar begrip is.
Je kan zien dat dit niet heel veilig is om te doen als bedrijf.
- Privacy,
- Dataveiligheid,
- Geen buitenlandse hosting,
- Geen abonnementskosten,
- Geen geldstroom richting bedrijven en/of landen die je liever niet steunt,
- Tot op zekere hoogte autonomie, digitale soevereiniteit.
[Reactie gewijzigd door nms2003 op 10 augustus 2026 20:18]
En om alvast een volgende misvatting voor te zijn: de EU AI Act is wél nieuw genoeg maar kent het hele "extern LLM" concept niet. Als iets niet in een extern LLM mag, dan ook niet in een intern LLM.

Als kleinere partij idem met dit soort kleine modellen. Als particulier is het ook gewoon leuk. Maar het is ook prettig om zeker te weten dat je prive data niet meegenomen wordt in de volgende trainingsronde van een online model.
Verder kan je hiermee offline werken. Voor sommige partijen is dat essentieel (airgapped netwerk ivm security).
En dan heb je nog de hobby factor. Natuurlijk kunnen online modellen het beter. Maar hoe cool is het om hiermee te rommelen in de avonduren zonder verdere kosten. En te leren hoe deze dingen werken door het zelf te doen.
[Reactie gewijzigd door Eriky op 11 augustus 2026 08:03]

Wanneer ik een bestaand model benader gaat het al fout met de wetsartikelen die al openbaar zijn en worden veel clausules uit de normen verkeerd uitgelegd
Als je bronnen hebt waar je een LLM mee traint, dan kun je die ook gebruiken voor RAG. Dat is zowel juridisch juist als technisch juist.
"Scraping" is irrelevant. Als dat kan, dan kan het voor beide gevallen (RAG en training). Als dat mag dan mag dat.
Koppelen? Laat dat aan de LLM zelf over.
Je kunt er nu nog inderdaad niet zo veel op dan de grote publieke modellen. Over 5 of 10 jaar kan dit er echter wel heel anders uit zien. En dan is het de vraag hoe bedrijven eigenlijk geld/marktaandeel kunnen oogsten met AI tools. Want publiek hosten lijkt tot nu toe niet winstgevend voor de aanbieders, dus ook daar is het logisch dat er iets gaat veranderen.
[Reactie gewijzigd door Bertje3000 op 10 augustus 2026 23:38]
Nu het LLM verhaal, waarom nu inzetten op een open weights model? Steve Balmer zei het ooit goed.. developers,developers,developers..
Meta probeert misschien niet de AI-markt te winnen door het beste model te bezitten, maar door ervoor te zorgen dat zoveel mogelijk developers hún model als bouwsteen gebruiken.
Dat is alsnog een forse hoeveelheid VRam; niet bepaald een ‘gewone’ PC, zeker niet in deze dure RAM-tijden.

Bijvoorbeeld qwen 3.6 35B op een RTX 3080 TI 12GB gaat als een trein.

Dat maakt het dus best interessant voor veel mensen.

Als je een 4090 hebt bijvoorbeeld dan heb je volledig afzonderlijk 24GB VRAM los van de gewone RAM en kan je het volledig offloaden.
Ikzelf kan vrijwel niks met lokale LLM's in praktische nut op mijn 16GB GPU. Alleen een gewoon licht 'chat' model wel, maar iets van programmeren is al volkomen nutteloos. En laten die 24GB GPU's al niet te betalen zijn, precies hierdoor.
met Mix of experts (MOE) kun je nog veel grotere modellen draaien (mits genoeg ram, omdat alleen die "actieve"experts uit het model naar vram gaan.
Je moet alleen iets anders werken met de kleinere modellen
Aanrader is Matt Pocock , zijn flow is zeer geschikt voor local llm, of mix van local en cloud
llama-server.exe -m E:/llama/models/Qwen3.6-35B-A3B-UD-Q4_K_XL.gguf --fit on --fit-ctx 128000 --fit-target 256 -np 1 -fa on --no-mmap --mlock -b 2048 -ub 2048 -ctk q8_0 -ctv q8_0 --temp 0.6 --top-p 0.95 --top-k 20 --min-p 0.0 --presence-penalty 0.0 --repeat-penalty 1.0 --reasoning-budget -1 --chat-template-kwargs "{\"preserve_thinking\": true}"

 )

Als je een 32gb Mac mini of één 3090 hebt, dan kun je prima een qwen 27b of Gemma 4 26b model runnen, in 4 bit precision. Of je dan kiest voor de normale "basis"/base versie van het model of een fine tune danwel distill maakt voor de hardware requirements niet zoveel uit.
Ook met een 16gb Mac of een 3060 kom je best een end met wat kleinere modellen. Desnoods run je het model grotendeels op CPU met alleen een deel op GPU.
Je kunt van alles vinden op huggingface, van fine tuning voor programeren, voor het schrijven van verhalen, voor agentic use, voor NSFW, etc etc. Je kan het zo gek nog niet bedenken of het bestaat.
Nou nou, er zijn anders genoeg mensen die dit wel kunnen draaien. De truuk is om een mobile chipset te gebruiken, deze gebruiken namelijk een deel van het systeemram als VRAM. Zo kan je met een "strix halo" setup tot 128GB aan shared memory krijgen, en dus ook gewoon de grotere modellen draaien. Zie bijvoorbeeld https://strix-halo-toolboxes.com/#strix. Maar ook op "normale" laptops met een bijvoorbeeld een AMD AI chipset kan je prima grote modellen draaien, zolang je maar genoeg systeemgeheugen hebt.Om het model lokaal, op een 'gewone' Mac of pc, te laten draaien, moest het flink verkleind worden. Volgens Meta heeft een model van 30 miljard parameters bij volledige precisie ruim 55GB geheugen nodig. Een consumenten-gpu biedt die ruimte niet.
Voor desktop GPUs is dit inderdaad een interessant model, maar dan moet je nog steeds een stevige GPU hebben. Een intel ARC Pro B60 is dan goedkoop a €720, maar geen idee hoe performant dat is. En een Radeon R9700 zit alweer op €1400. En dan hebben we het over workstation kaarten, laat staan gewone gaming GPUs zoals een RTX 5090 van €4000+.
Niet dat een strix halo systeem goedkoop is, maar dan heb je tenminste een compleet systeem, ipv alleen een GPU.
Neemt niet weg dat het goed is dat modellen kleiner worden, dat maakt de barrier to entry om lokaal serieuze modellen te draaien hopelijk lager.

Meta is trouwens ook relatief goed in ‘benchmaxen’, ik betwijfel of deze muse glimmer release veel gebruikers gaat hebben in de praktijk.
Om te kunnen reageren moet je ingelogd zijn